核心观点:自动 Compaction 通常先解决“上下文会不会装满”,但长时间工作的 Agent 更需要回答另一个问题:哪些信息已经完成使命,为什么还要在之后的每一轮调用中继续携带它们?
用 Claude Code、Codex 或 DSH 连接 Unreal Engine 编辑器时,我反复遇到同一种状况:一个材质节点修改或 Shader 编译,工具可能返回上千行日志、整个蓝图的属性、重复的错误堆栈。某轮排查结束以后,这些原始文本大多不再具有直接价值,却依旧留在会话历史里。
这与阅读源码的 Agent 不完全一样。源码通常有清楚的路径、符号和差异;UE Editor 的工具输出往往是一份高体积、低密度、随时间失效的状态快照。
问题不是上下文窗口不够大,而是我们把上下文窗口当成了日志仓库。
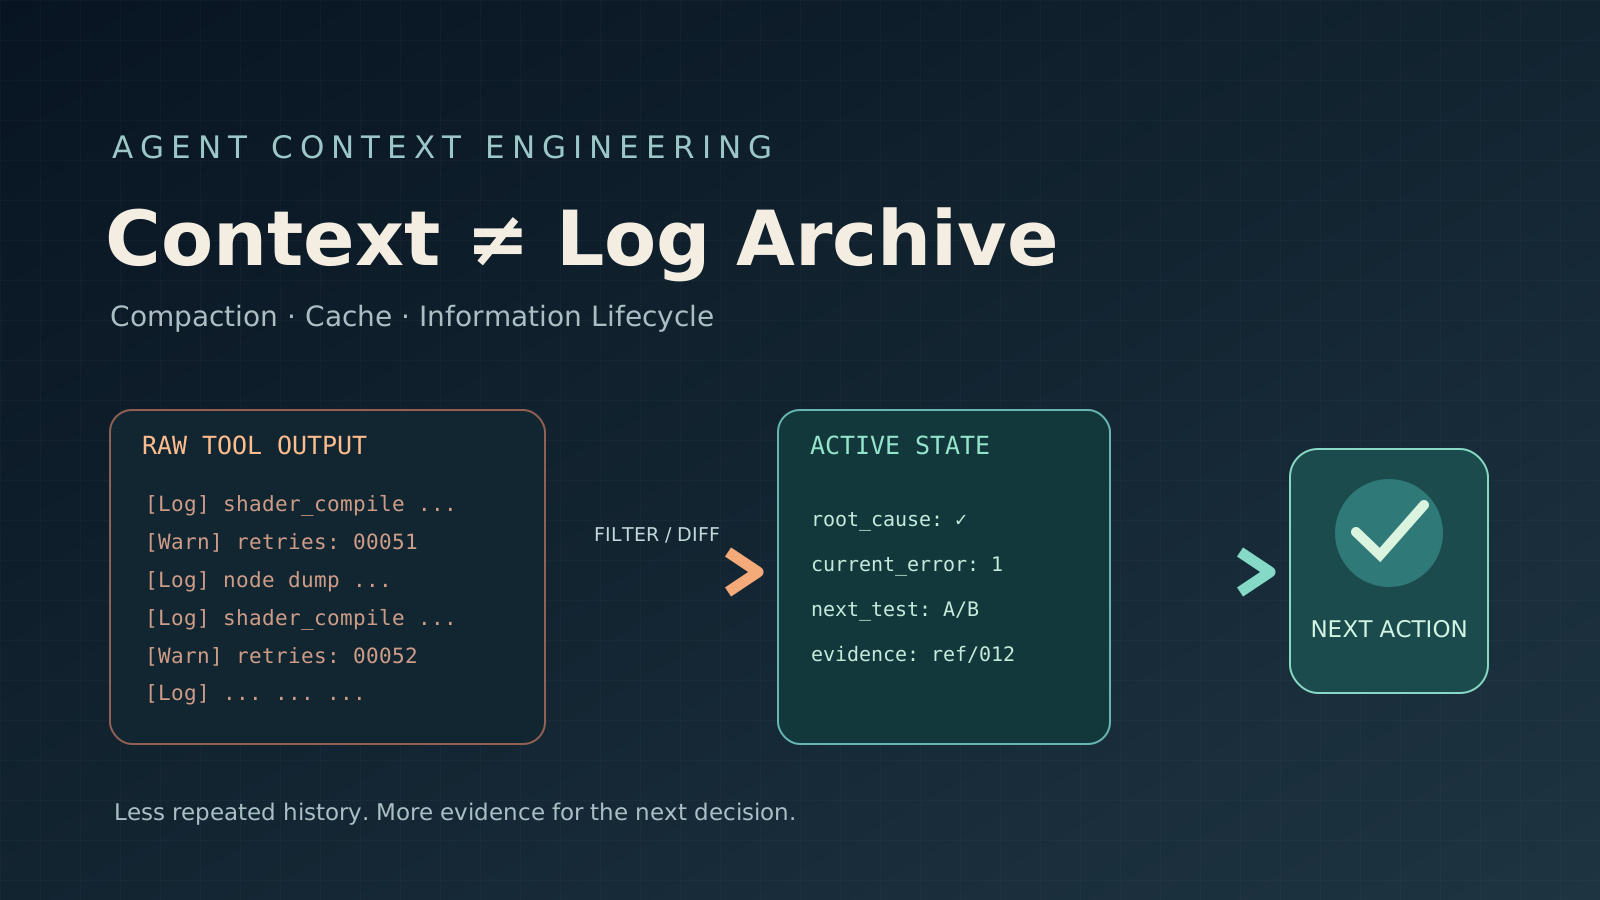
封面为本文的概念数据流示意,不表示真实基准测量;下文所有数值示例均标注假设。
一、上下文窗口、累计 Token 与缓存,是三个不同的量
一次模型调用中的上下文,可以粗略分为:
当前请求上下文
├── 系统指令 / 工具定义 / 项目规则
├── 仍然相关的任务事实与代码
├── 历史消息与历史工具结果
└── 当前问题窗口大小衡量的是单次能看到多少,不是整段会话消耗了多少。长会话的累计输入量,来自每一次调用对这份上下文的反复携带:
累计输入 Token ≈ 各次模型调用的输入 Token 之和假设一个 Agent 的当前上下文维持在 400K Token,之后执行 50 次工具调用与回复,即使历史没有继续增长,也相当于累计处理约 20M 输入 Token。这不是 20M 的未缓存计费量,但它解释了为什么“只问了几个小问题”也可能造成很大的用量。
Prompt Cache 降低的是相同前缀的计算与价格,不是把缓存内容从上下文窗口里移除。 假设缓存读取价格为普通输入的 10%,20M 次累计缓存读取仍相当于约 2M 普通输入 Token 的成本;这里尚未计入首次写入缓存、未命中部分、输出和压缩开销。
相反,如果能在同一阶段把历史从 400K 整理到 80K,那么后续 50 次调用只携带约 4M 输入 Token。两者的差距会随着调用次数放大。
这只是固定上下文规模的教学示例,不是任何产品的实际账单。现实里的前缀变化、缓存过期、输出预算、模型单价与订阅配额都会改变最终结果。
真正值得关注的指标不是单次上下文的占用率,而是:完成一次任务,需要多少累计的有效计费 Token?
二、Claude Code 与 Codex 的原生 Compact 在做什么?
Claude Code:将旧历史整理成新的叙述
Claude Code 的 /compact 通过模型总结当前对话,保留关键任务目标、已确认的决策、修改进度和未解决的问题,用更短的摘要替代旧历史。自动压缩则通常在上下文接近配置阈值时触发。
它的优点是直接、集成成熟,适合持续推进同一件事;缺点是摘要有损。如果早期出现过一个当时看似不重要、后来却必须重新检查的警告,自动摘要不一定能预知它未来的价值。
Anthropic 在《Using Claude Code: session management and 1M context》中甚至特别指出:过长历史可能造成 context rot,而自动压缩恰好可能发生在模型已经承载大量干扰信息的时候。因此官方除了自动压缩,也建议主动使用 /compact、/clear、/rewind 与 Subagent。
Codex:用专门的 Compaction 机制延续状态
Codex 早期也使用普通文本摘要。OpenAI 后来公布,Codex 会通过 Responses 的 /responses/compact 机制,把旧历史替换成较小的一组输入项,其中可能包含不透明的 type=compaction 项和 encrypted_content。
这不等于可读摘要,也不意味着无损恢复每条原始消息。可以把它理解为一种面向模型继续工作的压缩状态。它对任务延续有价值,却不能取代外部保存的编译日志、文件和验证证据。
两者的共同特征是:原生 Auto Compact 以容量管理为重要触发条件。它们可以防止窗口溢出,但不保证某条已经失效的工具日志会在产生后立即从历史中消失。
三、billion-context 的不同:分段压缩、按需恢复、模型参与决策
DSH 可用的 billion-context(简称 bili)尝试改变压缩的粒度和时机。根据其公开实现,它会为 Agent 提供四种上下文工具:
| 工具 | 作用 |
|---|---|
compress | 把某一段历史折叠为摘要 |
decompress | 需要时恢复已折叠的原始内容 |
search_context | 搜索历史摘要及对应内容 |
acp_status | 查看压缩区间和当前状态 |
不同于“窗口快满时总结整段会话”,bili 允许模型随着任务推进,逐步处理已经消费过的历史。项目文档中还描述了按上下文增长量发出的提醒,默认约每新增 50K 可压缩 Token 提醒一次;在窗口压力更高时还会进一步加强提醒或启用兜底机制。具体行为应以客户端、插件版本和配置为准。
例如 UE 材质编译连续失败了十次:已经定位的前九次错误可以压缩为“试过什么、为什么失败”;最新的代码、错误位置和下一轮实验条件则应保持可见。若之后要核对某次错误的精确报文,再从历史记录中恢复,而不是要求模型凭摘要回忆。
但这里的“可逆”有边界:原始消息可被存储和检索,不等于摘要无损,也不等于模型一定知道该检索哪一条。 bili 额外注入的工具说明、压缩摘要、搜索与恢复同样会消耗 Token。项目宣传的节省倍数和缓存命中率是其自述结果,不能直接当作每个模型和中转服务的保证值。
三种策略的本质区别
| 维度 | Claude Code | Codex | billion-context |
|---|---|---|---|
| 主要机制 | 历史摘要 | 原生压缩状态 | 历史分段折叠与恢复 |
| 常见触发方式 | 自动阈值 / 手动 | 自动阈值 / 手动 | 增长提醒 + 模型选择 + 兜底 |
| 早期细节找回 | 重新读取原始资料或历史 | 重新读取外部证据 | 可搜索 / 解压已保存历史 |
| 核心优势 | 原生集成、简单 | 原生状态延续 | 历史可检索、可局部处理 |
| 主要风险 | 摘要遗漏关键事实 | 压缩状态不透明 | 模型误判压缩或恢复时机 |
四、压缩本身要钱吗?要,而且可能影响缓存
所有有意义的压缩都需要某种计算:Claude Code 需要生成摘要;Codex 的 Compaction API 也会产生可统计的用量;bili 需要模型生成摘要并进行工具交互,有时还会再搜索和解压。
因此不能只计算“压缩后少了多少 Token”,还应计算:
总成本 ≈
  未缓存输入成本
+ 缓存写入成本
+ 缓存读取成本
+ 模型输出与推理成本
+ 压缩、恢复、重新查询的增量成本
压缩也可能改变历史前缀,让部分 Prompt Cache 无法复用。反过来,不压缩并非免费:反复读取一个 300K 的缓存前缀,累计起来仍有成本。最佳压缩时机本质上是在比较两件事:
- 继续携带历史,未来还要付多少次缓存读取成本?
- 现在压缩,将付出多少摘要成本、缓存重建成本,以及丢失细节的风险?
这里还有一个容易误判的故障:通过 openai-completions 兼容协议中转 Claude Opus 时,客户端显示缓存命中 0,不一定代表上游真的没命中。中转站可能没有启用 Anthropic 缓存,或者只是没有正确透传 usage 字段。应同时查看服务端原始用量:Anthropic 的 cache_read_input_tokens / cache_creation_input_tokens,以及 OpenAI 兼容响应里的 cached_tokens,再判断是实际缓存失效还是统计映射缺失。
缓存命中率只是解释成本的辅助指标,不能代替实际计费与任务完成率。
五、为什么桌面端不把上下文压力一直显示出来?
这个问题已经有明确的社区反馈。
Claude Code Desktop 的 Issue #90708 请求恢复常驻的上下文使用率显示,因为用量额度圆环无法帮助开发者判断“何时应该压缩”。Codex 的 Issue #24272 也讨论过指示器被隐藏的问题;OpenAI 开发者回应称,用户对界面设计有相互矛盾的反馈,并恢复了可选的上下文显示。
所以不能简单推断“厂商故意隐藏上下文来增加消耗”。更合理的解释是:产品试图把 Compaction 包装成无需用户操心的基础设施,界面追求简洁,但这会削弱重度用户对长期成本与信息损失的掌控。
如果一套工具只展示“剩余订阅额度”,却不展示“当前上下文体积、历史工具输出体积、累计缓存读取、最近一次压缩”,那么用户就很难判断一次漫长任务究竟在推进,还是在不断重放已有历史。
2026 年 9 月的一份 Codex 社区故障报告 #46023 提供了一个极端但具体的案例:用户在约 2 小时 44 分钟内记录到约 2.423 亿累计 Token,其中绝大部分是反复读取缓存历史。它是个别用户报告,不能当成一般成本,但清楚展示了长会话和多 Agent 循环中可能出现的上下文放大效应。
六、UE 工具工作流需要的不是更大的窗口,而是信息生命周期
我认为应该把 UE 工具返回的信息分成三类:
| 信息类别 | 举例 | 最合适的处理方式 |
|---|---|---|
| 长期事实 | 已确认的根因、不可违反的约束、已修改文件 | 常驻任务记忆 |
| 当前工作集 | 最新 Shader、当前节点连接、待验证假设 | 保留在活跃上下文 |
| 可恢复证据 | 完整编译日志、Actor 全量状态、过期的实验输出 | 存文件,只返回摘要与定位索引 |
一次排查完成后的精简记录可能是:
issue: foliage_normal_black
engine: UE5.4 mobile
status: root_cause_confirmed
root_cause: normalize(cross(N, T)) degenerates
verified: A/B test reproduced the failure
constraints:
  - preserve PC/mobile visual parity
  - avoid extra dynamic branching
next: implement and validate cheap fallback
raw_evidence: debug/foliage_normal_012.json
与其把 80 页日志交给模型后再期待它执行 /compact,不如在 UE MCP 或 Python 工具出口就完成:错误去重、状态 Diff、按对象查询、只返回变化字段、将原始数据落盘并提供查询 ID。
我更倾向以下分层:
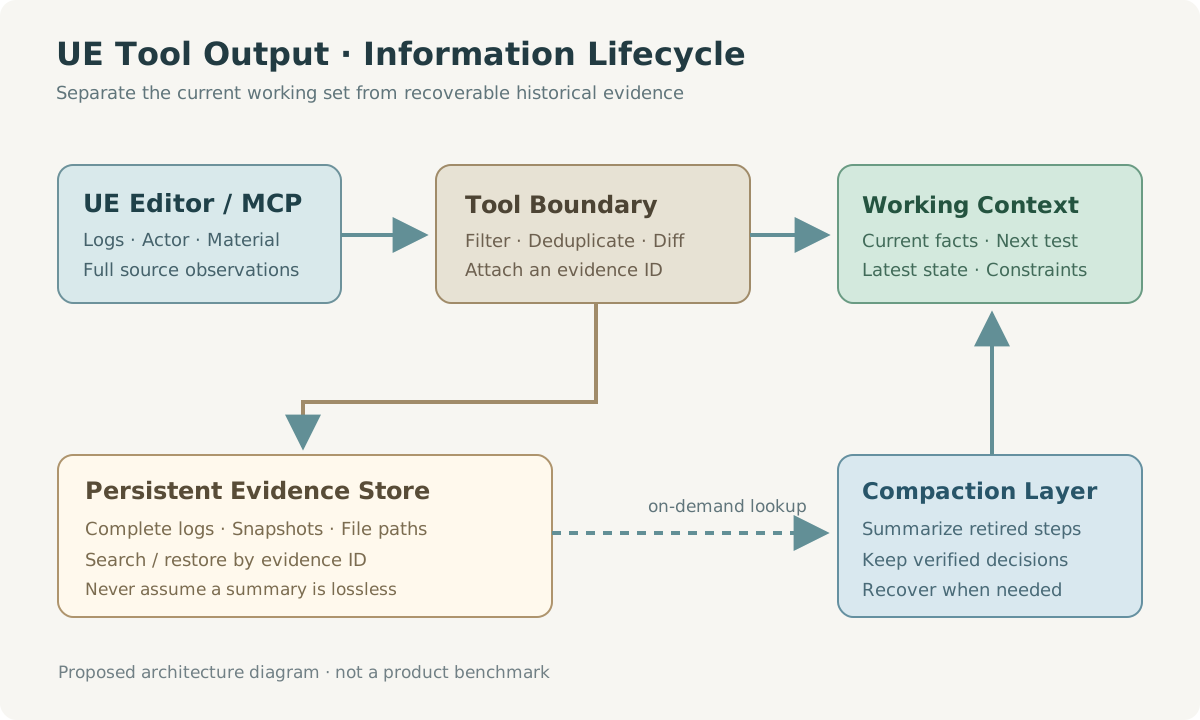
图示为建议的工程分层:箭头表示数据流,而不是某个 Harness 已内置这些功能。
UE Editor / MCP / Python
        │
        ▼
工具输出治理:去重、过滤、Diff、保存原始证据
        │
        ▼
活跃上下文:当前问题、关键事实、最新代码
        │
        ▼
会话压缩:Claude Code / Codex / billion-context
        │
        ▼
模型推理与下一次工具调用其中工具输出治理的收益最稳定,因为它在日志进入模型之前就消除了噪声,而且与最终选择 Claude Code、Codex 还是 DSH 无关。
七、应该全交给自动压缩吗?
不应该走向另一个极端:要求开发者时刻盯着 Token 百分比、每 20K 手工 Compact 一次,同样会打断开发。更好的设计应该是自动兜底 + 按任务语义回收 + 可恢复证据。
实际操作中,我会采用四个规则:
- 同一个根因尚未确认时,保留最新实验、关键代码和反证,不急于丢掉推理线索。
- 一次排查阶段结束时,主动归档已验证结论,压缩失败实验与重复日志;不必等到上下文快满。
- 开始新的独立任务时,优先新会话;对即将产生大量一次性输出的工作,使用独立 Agent,并只返回结论。
- 压缩前先保存证据,至少保留文件路径、节点 ID、参数、错误签名、时间或版本号,让将来的检索有据可依。
这也符合官方工程文档的方向:Anthropic 推荐根据“继续、回退、压缩、清空、子 Agent”五种情境作选择;OpenAI 则建议在完成调试阶段或缩小根因范围等里程碑后实施 Compaction。
如何判断 billion-context 是否真的适合自己?
不要只比较压缩率。找几类真实任务——例如材质编译错误、蓝图节点修改、移动端法线退化排查——以相同模型、工具和输入分别测试:原生 Auto、主动阶段性压缩、bili 增量压缩。
记录任务是否完成、是否遗忘已验证事实、累计未缓存输入、缓存写入/读取、输出与压缩成本、总耗时、工具调用次数。如果某一种方案节省了 50% 输入,却让 Agent 反复恢复历史或重做已经失败的实验,它未必更优。
另一个经常被混淆的设置是 Reasoning Effort:high / xhigh / max 决定模型在当前信息上投入多少推理,不负责决定哪些历史值得留在上下文里。用 Max 分析一万行重复日志,并不能修复日志本身的信息密度问题。
结语:上下文应该是工作内存,不是历史数据库
Claude Code 和 Codex 的原生压缩越来越成熟;billion-context 的增量、可检索思路则展示了另一种路线。它们并不是简单的“哪个压缩倍率更大”的竞争。
更重要的变化是,我们开始把上下文当成一种需要管理生命周期的资源:最新状态留在工作内存,确定结论写入长期记忆,完整证据放入可查询存储。
Agent 的目标不是记住发生过的每一行日志,而是保留足以做出下一次正确决策的信息。
真正值得优化的不是最大上下文窗口,而是每个有效 Token 能推动多少真实工作。
参考资料
- Anthropic, Using Claude Code: session management and 1M context, 2026-04-15.
- Anthropic, Effective context engineering for AI agents, 2025-09-29.
- Anthropic, Compaction overview 与 Context editing.
- OpenAI, Unrolling the Codex agent loop, 2026-01-23.
- OpenAI, API deployment checklist: Leverage compaction 与 Compaction.
- billion-context GitHub / 中文说明.
- Claude Code Desktop 上下文指示器反馈 #90708;Codex 界面反馈 #24272.
- Codex 长会话 Token 放大案例 #46023.
- Anthropic, Prompt caching;OpenAI, Prompt caching.
资料核对至 2026-11-03。社区 Issue 是个案,插件性能数字属于项目自述;本文中的成本计算为解释机制的示例,不代表任何特定用户的账单。