本周速览
本期覆盖 2026-10-10 至 2026-10-16,并按合并周刊规则从近两周窗口补入两篇 2026-10-08 的重要论文。主线是:越来越多图形问题不再只优化最终像素,而是显式优化时间相关性、感知频带、接触约束与材质条件。这对 TA 的意义很直接——比起继续堆一个更强的通用滤镜,先把“哪些量必须稳定、哪些误差可被感知系统隐藏、哪些自由度值得进入求解器”定义清楚,往往更接近可控的生产方案。
本期深读 Tabula Rasa。它把时序一致的噪声写成一个 Monte Carlo 重建问题,再用数据库里的 Sketch 思想估计方差,使噪声既能随三维可见点运动,又尽量保持扩散模型和随机材质所要求的单位方差。它不是一个可直接替换 TAA 的抗锯齿器,但对雨丝、粒子、程序纹理与神经后处理中的“稳定随机源”很有启发。
精选新闻
1. 深读|Tabula Rasa:让噪声跟随三维运动,同时守住单位方差
- 来源 / 作者:Tobias Ritschel、Yang Zhou、Nick Milef、Mikhail Dereviannykh、Chen Liu、Christophe Hery、Carl Marshall
- 原始发布日期:2026-10-08(近两周补充)
- 原文:Tabula Rasa: Monte Carlo estimation of unit-variance noise with controlled spatio-temporal correlation
- 代码:facebookresearch/Tabula-Rasa
- 主题:Temporal Coherence、Monte Carlo、Procedural Noise、TAA、WebGPU、Neural Rendering
发生了什么
时间相关噪声有两个看似冲突的目标。第一,落在同一世界空间位置上的随机值应该跨帧一致,即使它先被遮挡、之后又在另一个像素重新出现;第二,每一帧送入扩散或随机效果的噪声仍要保持零均值、单位方差。只把上一帧噪声用 Motion Vector Warp 到当前帧,容易在遮挡、裁剪、放大和缩小时失去三维一致性;直接把多个随机变量滤进一个像素,又会按大数定律降低方差。
Tabula Rasa 把一个像素看成对三维随机场的 Monte Carlo 重建。若一个像素覆盖若干相互独立、单位方差的随机变量 F_i,覆盖比例为 a_i,则重建值为:
P = Σ a_i F_i
Var(P) = Σ a_i²
P_corrected = P / sqrt(Σ a_i²)
困难是运行时既不知道像素覆盖了多少个随机变量,也不能给每个像素维护一个巨大直方图。论文的关键做法是“双哈希 + 小直方图”:大哈希把世界空间格点映射到稳定的随机种子;小哈希把这些格点压进每线程几十到几百个 Bin,用命中频率近似各 a_i,再计算方差校正。这个紧凑统计就是从数据库 Cardinality Sketch 借来的部分。
核心技术与新意
- 三维相关性来自路径本身,而不是 2D 光流:随机键可由 Primary Hit、完美反射或折射后的三维格点生成。Perspective、Occlusion 和 Disocclusion 因此自然进入相关性;同一三维点重新可见时会取回同一随机值。
- 同时估计像素值与方差:同一组 MC/QMC 样本既累计随机值,也累计小直方图。实验显示 Bin 太少会把多个变量合并,导致方差明显低于 1;论文多数结果采用 64 个 Bin,属于质量、寄存器/本地内存和 Atomic Contention 的折中,而不是普适常数。
- LOD 不是附加项:极端 Minification 下,少量样本无法可靠数清大量随机变量。方法借用程序纹理的 Band Limiting,根据映射 Jacobian 估算 Footprint,并 Clamp 掉会被像素滤掉的高频 Band,避免方差估计自身噪声过大。
- 时间可随机访问:每帧只依赖确定性的三维映射和种子,不要求先算
t-1才能得到t。因此帧之间可以并行;这与历史 Buffer 型 Temporal Filter 的依赖链不同。
论文报告在 A100 上生成一张 1024×1024 噪声帧约 2.44 ms;JAX 版本可把不同帧分配到多张 GPU,WebGPU 版本则利用硬件 Rasterization 与 Fragment Derivative 计算 Footprint。这个数字只代表论文的噪声生成任务,不等于在 UE 中叠加完整 GBuffer、粒子和后处理后的帧耗。
TA 实践价值
它最适合迁移的不是完整视频扩散流程,而是“稳定随机源”这一层。对细雨、火花、Dithered Opacity、随机透明、程序纹理或神经后处理,可把随机值绑定到稳定的 World Position / Primitive ID,而不是绑定 Screen Pixel;再用 Footprint 估计和方差归一化检查放大、缩小与遮挡后的统计是否漂移。
在 UE5 中可以先做一个简化 Compute Pass:输入当前深度、Primitive ID、World Position 和上一帧相机矩阵;对每像素采 8–32 个 Subpixel,使用 hash(worldCell, globalSeed) 生成高斯值,再用 32 或 64 Bin 的紧凑直方图估计 Σa_i²。它不需要替换 TAA,而是给 TAA 提供一个更稳定、统计量更可控的随机信号。
限制与阅读建议
- 论文的强项是生成时间相关噪声,不是直接解决几何边缘、Specular Aliasing 或透明排序;把它等同于 TAA 会误读结论。
- 支持的是能返回唯一命中点的映射;带分布的粗糙反射、多次弹射和复杂体积路径会让“一个样本属于哪个稳定随机变量”变得不清晰。
- 小哈希会碰撞,极端 Minification / Magnification 下仍可能破坏单位方差;更多 Bin 主要增加存储与并发压力。
- 代码已公开,包含 JAX 参考实现与纯 GPU 的 WebGPU Mesh Demo;项目主体为 CC-BY-NC,商用管线不能把它当作无条件可集成的 MIT/BSD 组件。
- 深度阅读成本约 45–60 分钟。先看图 1–3 和第 3 节的
Σa_i²推导,再看第 5 节性能与 Super Resolution 实验;实现者最后读 Footprint/Clamping 和 WebGPU 版本。论文页使用 arXiv 非独占分发许可,因此本期没有复制论文插图。
2. HoOPOE:全息显示不再只最小化像素误差,而是优化时空与颜色频带
- 来源 / 作者:University of Rochester、UNC、Meta;Ethan Chen 等
- 原始发布日期:2026-10-13(arXiv v1 为 2026-10-12 22 UTC,换算上海日期)
- 原文:HoOPOE: A Holography-Optimized Perceptual ObjectivE function
- 主题:XR、Holographic Display、Perceptual Loss、Temporal Multiplexing、Color
发生了什么
相干光全息显示必须用有限 SLM 像素重建光场,Speckle 无法像普通显示伪影那样仅靠校准消除。已有 CVVDP、LPIPS、DISTS 等感知指标适合做质量评价,却未必适合直接当优化目标:优化器可能找到“指标认为很好、真人看起来很糟”的对抗性刺激。
HoOPOE 为计算全息构造了专用损失。它先把参考与预测视频变到对立色空间,再用 Laplacian Pyramid 拆成空间频带;每个空间/颜色 Band 又沿时间轴做频带分解。最终损失是这些时空颜色 Bin 上的加权 MSE,权重通过全息优化中会实际出现的刺激来标定。这样既保留近似二次、易优化的梯度,又能表达“高时间频率 Speckle 比低频闪烁更不显眼”。
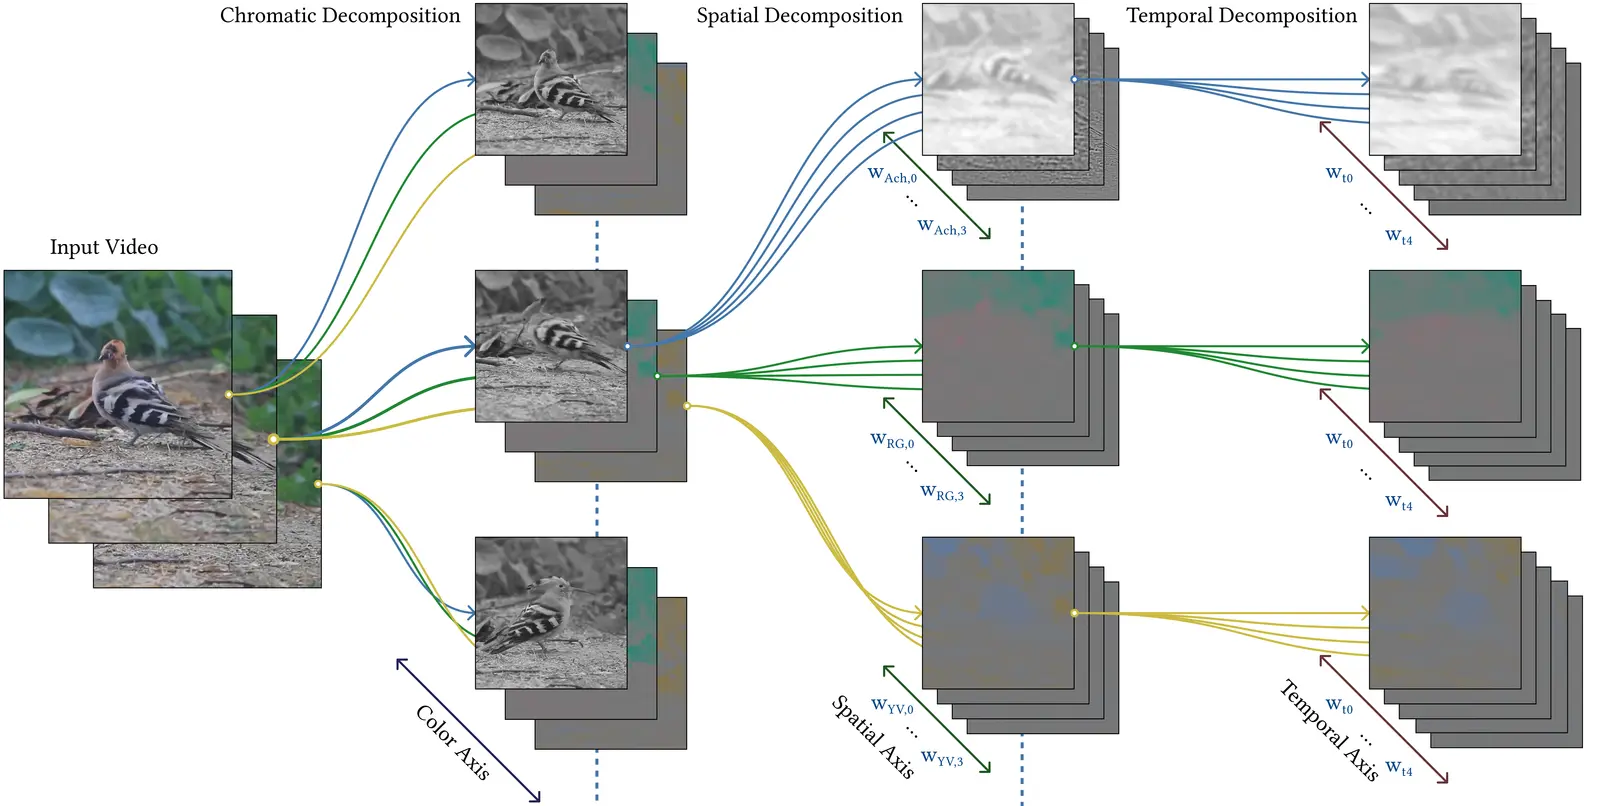
图:HoOPOE 的时空颜色频带分解。来源:论文作者,依据论文的 CC BY 4.0 授权转载;原图中的示例视频来自 Ram(CC BY),本站仅转为 WebP 并缩放。
核心技术与新意
- 损失不是单张图上的 Color Difference,而是
color × spatial-frequency × temporal-frequency三维频带上的加权误差。 - 它明确区分“好用的评价指标”和“可被梯度下降安全优化的目标”。复杂指标的相关性高,不代表其优化景观或训练分布外行为可靠。
- 在物理显示用户研究中,参与者平均 68% 的比较选择 HoOPOE,优于次佳目标;论文还观察到从 120 fps 提高到 240 fps 的收益明显,而 240→480 fps 的差异未达到显著水平。这不是通用 VR 刷新率结论,而是该全息系统和内容下的结果。
TA 实践价值
这套思路可迁移到 HDR、TAA、Frame Generation 和 Foveated Rendering 的评测设计:先把目标伪影放进人眼敏感的时空频带,再决定 Loss 与权重,而不是只看单帧 PSNR/SSIM。尤其是透明雨丝、细枝、头发和高亮滚动时,单帧误差小并不代表运动中不闪;可以把固定 Camera Path 的 Capture 做成时空 Laplacian 分解,分别追踪低频拖影和高频闪烁。
限制与阅读建议
方法针对 CGH Speckle 和特定物理显示标定,不应直接把权重复制到普通 OLED、HDR 电视或头显;感知偏好也受亮度、视距、FOV、内容和 SLM 响应影响。阅读成本 30–45 分钟:优先看图 2–3、第 3 节 Loss 结构、第 5 节用户研究,以及讨论中的 120/240/480 fps 结果。
3. DiffGIPC:12 个运动自由度保留高分辨率接触,GPU 上完成可微 IPC
- 来源 / 作者:University of Hong Kong、TransGP、Carnegie Mellon University;Kemeng Huang 等
- 原始发布日期:2026-10-14(arXiv v1 为 2026-10-13 19 UTC,换算上海日期)
- 原文:DiffGIPC: Differentiable Mixed-Coordinate Contact Dynamics on GPU
- 主题:DCC、Differentiable Simulation、Cloth、Contact、CUDA、PyTorch
发生了什么
可微物理需要反复执行前向模拟和反向梯度。对衣物、软体与近刚体接触,Penalty 或速度级约束可能产生穿透与位置漂移;IPC 用几何 Barrier 和 Continuous Collision Detection 保证从可行初态出发的非穿透,但 Full-space FEM 会让几乎不变形的高模刚体也携带大量顶点自由度,拖大每帧伴随系统。
DiffGIPC 把真正需要局部变形的对象留在 FEM 坐标;近刚体改用 Affine Body Dynamics,每个物体只有 3 个平移加 3×3 仿射矩阵,共 12 个运动自由度。高分辨率表面仍参与碰撞和摩擦,只是通过位置 Jacobian 把点空间导数映射回 12 维块。每帧只解一个耦合 FEM–Affine 伴随系统,随后在 GPU 上并行累积 Rest Shape、初速度、材质、摩擦和关节控制梯度。
核心技术与新意
- 非穿透约束不是后处理:GIPC 的 Squared-log Barrier 和 CCD 仍处在前向 Incremental Potential 中,反向传播沿同一接触、摩擦与时间依赖链展开。
- 仿射体增加表面三角形会增加 Contact Detection 成本,却不会扩大线性系统里的运动块;这把“几何分辨率”和“运动自由度”拆开。
- PCG 迭代和收敛判断通过 Conditional CUDA Graphs 留在 GPU,减少小型紧凑系统中逐迭代 Kernel Launch 与 CPU–GPU 同步反而占主导的问题。
- PyTorch 接口负责把用户参数映射到物理量和 Loss,适合做形状设计、参数识别、摆放优化和关节控制,而不是只提供一个固定 Demo。
TA 实践价值
对 DCC/TA,这比“端到端神经布料”更接近可控工具:碰撞仍有明确几何约束,优化器只负责搜索 Rest Shape、初态或控制参数。可设想用于挂钩/衣架形状、服装稳定支撑、道具堆叠、软体关卡机关和碰撞参数反演。即使不复现求解器,也值得借鉴它的表示原则:高模可用于接触,但不应默认成为求解器的全部自由度。
性能、限制与阅读建议
与 CPU DiffIPC 的共享 Full-space FEM 案例相比,论文报告完整反向计算快 12.3×–34.1×,前向加反向快 10.6×–60.9×;两边分别是 RTX 4090 和 i9-13900K,属于跨硬件、跨实现的系统比较。摘要中的峰值 150× 与 4133.3× 分别还叠加了 GPU 化和 Affine 表示的收益,不能解读为“同一 Kernel 单点加速”。最高分辨率 Bunny 案例中,DiffGIPC 内部 ABD+ABD 的前向加反向约 0.37 秒,FEM+FEM 约 10 秒,更能说明表示压缩的贡献。
当前假设单条可微轨迹内 Mesh Connectivity 固定;可在优化步之间重网格,但不对重网格和顶点转移求导。论文写明代码将发布,本期核验时未找到对应公开仓库。阅读成本 40–60 分钟:先看图 2 与第 3–4 节的耦合伴随,再看第 6 节 CUDA Graph、表 1/3/5 的口径;不要只看摘要峰值。
4. 近两周补充|镜面 NRC:把反射方向与粗糙度直接写进在线辐射缓存
- 来源 / 作者:Dmitrii Klepikov、Vladimir Frolov
- 原始发布日期:2026-10-08(近两周补充)
- 原文:Neural Caching of Prefiltered Radiance for Specular Lighting
- 主题:PBR、GGX、Neural Radiance Caching、Path Tracing、Falcor
发生了什么
通用 Neural Radiance Cache 擅长用在线训练的小 MLP 近似间接光,但镜面项同时依赖位置、视线反射方向和 Roughness,普通位置—方向缓存不容易覆盖从镜面到宽 Glossy Lobe 的变化。新方法让缓存查询显式变成:
q = (hashGrid(position), reflect(view, normal), roughness)MLP 不直接输出最终 BRDF 积分,而是预测 Roughness 条件下的 Prefiltered Incoming Radiance;随后像实时 IBL 一样,与预计算的 BRDF Integration LUT 组合,恢复 Fresnel 与几何项。这相当于把 UE 常见的 Split-sum IBL 结构搬进在线神经缓存。
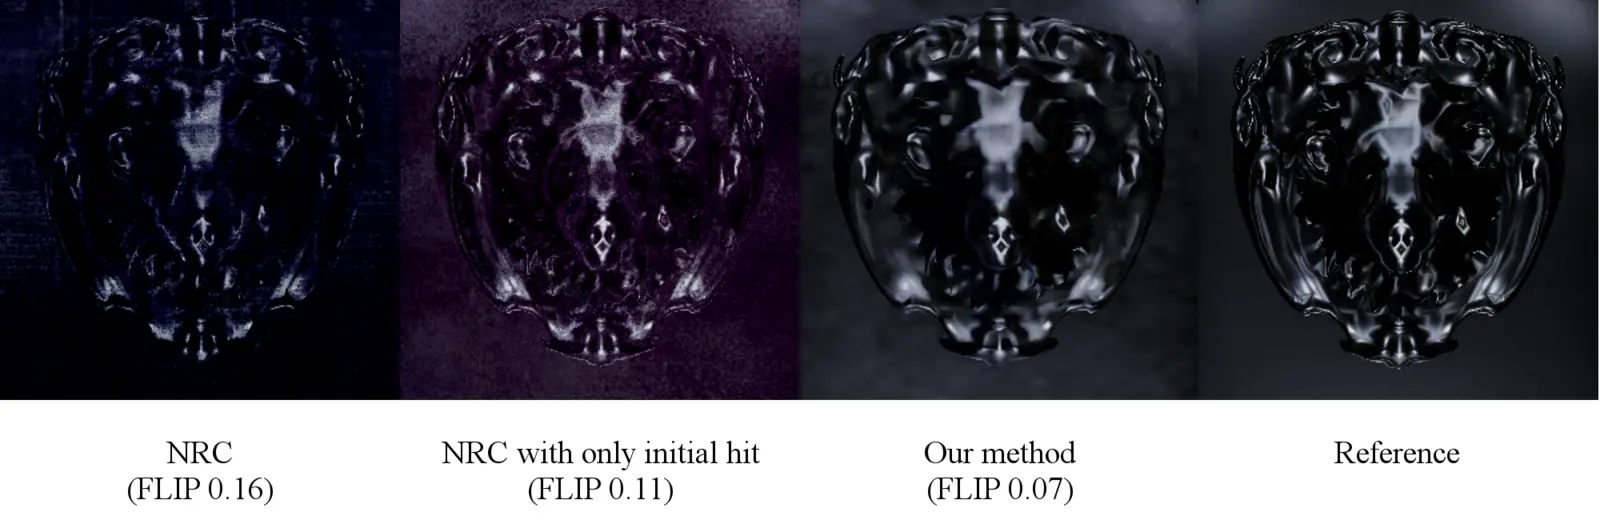
图:Specular Sponza 在 1000 帧后的对比,图中给出 FLIP 误差。来源:论文作者,依据 CC BY 4.0 授权转载;图片转为 WebP 并缩放,未改动内容。
核心技术与新意
训练与渲染分成三类工作:较长的 Training Path 生成多 Bounce 目标;较短的 Rendering Path 保存查询;最后批量调用 tiny-cuda-nn,并与 BRDF LUT 合成。网络使用 MSE 在线更新,再对权重做 EMA 以降低帧间波动。与“网络直接学最终 RGB”相比,结构中保留了 GGX、Schlick Fresnel 与 Split-sum 的已知先验,让 MLP 只学习最难缓存的入射光部分。
TA 实践价值
这对材质作者的启示是:神经缓存的条件必须覆盖会显著改变 Lobe 的材质参数。若 Roughness 不进入缓存 Key,不同高光宽度可能被平均;若 Normal/Reflection Direction 的坐标空间不稳定,动态物体上会表现为 Cache Swimming。UE 实验可先不训练网络,而是建立一个 position × reflectionDir × roughnessBin 的离散缓存,验证 Roughness 分层是否真的减少 Glossy Ghosting,再决定是否引入 MLP。
限制与阅读建议
实验只有 Bunny 和 Specular Sponza,1920×1080、RTX 3080 Ti,参考图为 4000 帧积累;论文称相对基线没有可辨别的性能下降,但没有给出足以外推到 UE 的完整毫秒拆分。方法继承 Split-sum 在掠射角和 n=v Prefilter 假设下的误差,动态场景稳定性也仍待系统验证。阅读成本 20–30 分钟:看第 2.2 节 Split-sum、第 3 节 Query/Pass、第 4 节曲线与 1000 帧对比。
5. Codex 0.163:只读工具并行、即时 Steering 与 Sandbox 网络检查进入同一版本
- 来源 / 作者:OpenAI Codex GitHub Releases
- 原始发布日期:2026-10-16(上海日期;UTC 为 2026-10-15 21)
- 原文:Codex 0.163.0 Release
- 主题:AI Coding、Agent、Tool Orchestration、Sandbox、Workflow
发生了什么
0.163 的增量集中在 Agent 的“运行中控制”而非单纯模型能力:用户可在 Codex 正在回答时发送 Follow-up,立即改变当前 Turn;中断会同时停止 Code Mode Cell 及其嵌套工具。互不依赖的只读工具——例如 Skill、Memory 与历史查询——现在可以并行执行。/config 提供可搜索设置,/daemon 可在警告潜在中断后重启后台服务并自动重连。
安全侧也有实质修复:网络代理在 DNS Lookup 之前检查权限,拒绝重复 Host Header,并阻止 Credential Alias 绕过检查 Hook;保存线程恢复时会恢复其权限和网络批准,同时服从当前 Managed Policy 与显式 Override。
核心技术与新意
这几个功能组合后,长任务的控制流更明确:并行只读阶段加速上下文收集,写入仍需串行处理依赖;Steering 是当前 Turn 的控制信号,不必等完整回答结束;Interrupt 具备向嵌套调用传播的取消语义;恢复线程则把权限状态视为可持久化但可被当前策略收紧的状态。
TA 实践价值
渲染研发可以把“查 UE 源码、读 Shader Compiler 日志、检索 GPU Capture 说明”并行化,但把改材质函数、跑自动 Capture、比较 GPU 时间保持为有序阶段。最重要的工程点不是吞吐,而是取消与权限:如果用户指出测试场景不对,Agent 应停止仍在运行的 Capture/构建,而不是让旧任务继续污染结果目录。
限制与阅读建议
Release Note 没有提供并行只读工具对真实项目的速度、成本或正确率评测;它也不意味着所有工具都可安全并行,写操作、共享 GPU 和同一工作树仍需显式排他。阅读成本 8–12 分钟,重点看 New Features、权限恢复、网络代理三段;完整 Changelog 只在维护 CLI 或 Sandbox 集成时细读。
优先阅读顺序
| 优先级 | 内容 | 阅读成本 | 为什么先看 |
|---|---|---|---|
| 1 | Tabula Rasa | 45–60 分钟 | 直接把三维时序一致性、单位方差与 GPU 实现连成闭环,最容易转化为粒子/程序噪声实验 |
| 2 | HoOPOE | 30–45 分钟 | 清楚展示“评价指标不等于可优化损失”,对 XR、HDR 与时序质量体系都有方法论价值 |
| 3 | DiffGIPC | 40–60 分钟 | 适合 DCC、布料、道具与接触驱动工具;需仔细区分表示收益与跨硬件加速数字 |
| 4 | 镜面 Neural Radiance Cache | 20–30 分钟 | 与 PBR Roughness、Split-sum 和在线缓存直接相连,实现结构紧凑 |
| 5 | Codex 0.163 | 8–12 分钟 | 对长任务 Steering、取消传播和并行只读检索立即有用,但没有独立性能评测 |
本周动手实验
建议做一个世界空间相关随机源 + TAA 的细雨压力测试。目标不是复现 Tabula Rasa 全部算法,而是先回答:雨丝的随机性若从屏幕空间改为稳定的三维 Key,TAA 拖影和闪烁是否真的改善。
- 建立三组完全相同的细雨/细线 Sprite:A 使用
hash(pixel, frame);B 使用hash(primitiveId, worldCell, frameSeed);C 在 B 上增加一个简化方差归一化,按2×2或4×4Subpixel 采样统计唯一 Key 的覆盖比例。 - 固定 Camera Path、曝光、TAA 参数和粒子 Seed,录制静止、横移、快速转向、遮挡后重现四段 Capture。
- 除主观 A/B 外,记录三项:静止区域 32 帧像素方差、运动边缘拖尾长度、Disocclusion 后恢复到稳定亮度所需帧数。
- 分别测试 Screen-space UV、Absolute World Position 与 Object-relative Position。移动发射器若用 Absolute World Key,噪声可能像“粘在世界里”;Object-relative Key 则更适合跟随局部特效。
- 只有 B 明显稳定且统计方差漂移可见时,再实现 32/64 Bin Sketch 与 Footprint LOD;否则不要先为完整直方图付出寄存器和 Atomic 成本。
这是实验建议,并非本站已经完成的 UE 实测。成功标准不是单帧更干净,而是运动与遮挡变化时更少闪烁,同时不以更长的 TAA 历史拖尾交换稳定性。
趋势观察
本周最明显的趋势是图形管线把优化目标显式化:Tabula Rasa 约束随机场的方差和三维相关性,HoOPOE 约束人眼敏感的时空颜色频带,DiffGIPC 约束非穿透接触及其梯度。它们都不是再加一个黑盒网络,而是先保留物理或统计结构,再把学习与优化放进明确边界。
另一个趋势是表示压缩正在替代盲目的算力扩张:DiffGIPC 用 12 个运动自由度承载高模接触,镜面 NRC 让网络只学 Roughness 条件的 Prefiltered Radiance,Agent 则只并行无副作用的读取阶段。下一步更值得关注的不是“网络更大”,而是哪些状态可以压缩、哪些依赖必须保真。
来源与核验
- 检索截止:2026-10-16 09(Asia/Shanghai)。本期主窗口为 2026-10-10 至 2026-10-16;Tabula Rasa 与镜面 NRC 发布于 2026-10-08,按近两周补充明确标注。
- 论文日期以 arXiv Submission History 的 UTC 时间换算上海自然日;Codex Release 同时核对 GitHub 的
published_at。性能数字保留原作者的硬件、分辨率、基线和测量口径,不外推为 UE 项目的预期收益。 - 已检查 Epic Games / Unreal Engine 官方 YouTube 频道过去一周可确认的新内容;未发现日期、来源和技术密度均足以进入本期前五的更新,因此没有为固定检查项占位。
- 已与本站现有 W40、W41 全部 10 个主题和 URL 去重;仓库目前只有两期正式周刊,尚不足规范所说的最近 8 期。为避免连续重复,虽然本周有新的 3D Gaussian Splatting 论文,仍未把它作为主线收录。
- HoOPOE 与镜面 NRC 标注 CC BY 4.0,本期据此转载一张关键图并注明转换;Tabula Rasa 与 DiffGIPC 的 arXiv 页面仅显示非独占分发许可,因此未复制其论文图片。
- 本期未另发 Weekend Long Read;深读已合并在第 1 项。