本周速览
本期五条内容看似横跨光追、纹理、表面基元、超分与 Agent,实际指向同一种工程策略:不再每帧、每视图或每次会话重做整个系统,而是把稳定部分沉淀成可复用的局部状态,只更新真正变化的部分。
- 深读:DXR Clustered Geometry / Partitioned TLAS。 Microsoft 为 DXR 加入可共享的几何簇、局部分区 TLAS 与 GPU 间接构建,目标是把动态场景的加速结构成本从“整棵重建”改成“局部组装与更新”。
- Texture Consolidation。 将稀疏、多视角生成图先投影到纹理域,再以表面光流对齐、梯度域缝合,解决生成视图彼此不一致时的纹理整合问题。
- Honeycomb-Surfels。 用带一阶颜色场的软六边形表面元替代长尾高斯,减少重叠与 overdraw,同时压缩基元数量。
- AMD FSR SDK 2.4。 FSR 4.1.2 扩展至 RX 6000 与部分 Ryzen APU,Vulkan 的超分和帧生成补齐到 DX12 功能级;但 UE 插件和神经降噪仍有明确缺口。
- Codex 0.165。 Memory v2、外部 Agent 记忆导入、附着式线程分叉与多仓库导航开始把 Agent 从一次性会话推向可恢复的工程工作区。
收集窗口:2026-10-24 至 2026-10-30(上海自然日)。本期五项均在 7 日窗口内,无需使用 14 日补充位。
精选新闻
1. 深读|DXR 把加速结构拆成几何簇与局部分区
原文发布日期: 2026-10-28
来源: Microsoft DirectX Developer Blog:DirectX Raytracing — Clustered Geometry and Partitioned TLAS · Agility SDK 1.722 Preview 总览 · DirectX-Graphics-Samples
发生了什么
Agility SDK 1.722 Preview 为 DXR 增加三块可以组合使用的新能力:
- Clustered Geometry:先把最多 256 个三角形、256 个顶点构造成 Cluster Level Acceleration Structure(CLAS),再从若干 CLAS 组装 Cluster BLAS;同一份 CLAS 可以被多个 BLAS 共享。
- Partitioned TLAS(PTLAS):将实例按空间或更新频率分区,持久保存未变化分区,只重建发生变化的局部。
- Indirect RTAS Builds:通过
GetRTASOperationPrebuildInfo()与ExecuteIndirectRTASOperations()由 GPU 生成构建参数和数量,减少 CPU 逐个发起 AS 操作的串行开销。
这不是新的光追求交单元,而是新的加速结构组织与构建接口。它需要新驱动支持:预览时 NVIDIA 覆盖 RTX,AMD 以 RX 9000 支持 Clustered Geometry / PTLAS,Intel 覆盖 Arc B 与部分 Core Ultra;不同厂商与功能仍需逐项核对。
核心技术与新意
传统动态光追管线常把 BLAS/TLAS 看成较大的重建单元。Clustered Geometry 把“几何内容”和“场景装配”分开:拓扑稳定的局部先成为 CLAS,LOD、流送或实例组合变化时复用这些局部,只重新组装 Cluster BLAS。着色器侧可用 ClusterID() 与 PrimitiveIndex() 找到三角形属性;启用相应标志后,TriangleObjectPositions() 还可直接从加速结构取得三角形的物体空间位置。
动画网格没有 CLAS refit,官方给出的路线是 Cluster Template:离线从稳定拓扑生成模板;每帧计算当前顶点;实例化模板得到 CLAS;再构建 Cluster BLAS 并更新顶层结构。换句话说,复用的是拓扑和构建计划,不是上一帧的包围盒结果。
PTLAS 解决的是另一层局部性。静态或低频变化实例放入空间分区,频繁移动对象可进入全局分区。分区重叠越多,遍历效率越差;全局分区越大,局部重建越省但射线遍历越贵。这使分区策略成为新的内容与性能预算,而不是“打开开关即可加速”。
间接构建则把 CLAS → Cluster BLAS → PTLAS 的任务列表放到 GPU。一次 ExecuteIndirectRTASOperations() 内部的操作不保证顺序,有依赖的阶段必须拆成多次调用并插入屏障。这个同步细节很容易成为实现错误来源。
性能、限制与如何解读数字
Microsoft 的极端动态样例在 Radeon RX 9070 上从 1.2 FPS 提升到 79 FPS;每帧 AS 准备/构建从 788 ms 降到 3.11 ms,光追部分从 72.6 ms 降到 9.27 ms。总 AS 内存从 7519 MiB 降至 774 MiB,其中动画 AS 从 6794 MiB 降至 244 MiB,但 scratch 从约 10 MiB 增至约 705 MiB。
这些数字证明“最坏情况下反复重建巨型结构”可以被局部复用消除,不能外推为一般游戏帧率增益。样例特意放大了传统路径的构建成本;真实项目还要支付聚类、调度、scratch、分区重叠、驱动差异与着色属性寻址成本。1.722 也是 Preview,需要 Developer Mode、Shader Model 6.10 与预览驱动;UE5 主线目前没有把它封装成可直接启用的项目设置。
对 TA / UE5 的实际价值
它与 Nanite、meshlet、World Partition、几何流送拥有相似的数据局部性。真正值得提前做的不是等待一个 UE 勾选框,而是让现有内容管线能够回答:
- 哪些三角形簇拓扑稳定、可跨 LOD 或实例共享?
- 哪些实例只在局部空间内变化,哪些必须进入高频全局集合?
- 光栅与光追是否能引用同一份细粒度几何标识和材质数据?
- 资产构建是否保留了簇、分区与更新频率的统计信息?
可立即尝试: 在现有 Nanite / HLOD / World Partition 数据上做一个离线“光追局部性审计器”,按 128–256 三角形聚类,记录跨 LOD 可复用率;再按 streaming cell 与移动频率模拟 PTLAS 分区,输出每帧变更分区数、重叠率、估算 AS bytes 与 scratch 峰值。即使暂不接入预览 DXR API,这份数据也能揭示内容组织是否适合未来的局部重建路径。
阅读成本与建议: 约 35–45 分钟。先看原文的 Clustered Geometry、Animated Meshes、Partitioned TLAS 与 Performance 四节;实现者再读示例中的 D3D12RaytracingClusteredGeometry,重点检查阶段间 barrier 与 shader attribute addressing。
2. Texture Consolidation:在表面域对齐并缝合生成视图
原文发布日期: 2026-10-27(按 arXiv UTC 首发时间换算上海日期)
来源: 论文 HTML · arXiv · 官方代码(BSD-3-Clause)
发生了什么
论文处理一个很实际的问题:多视角生成器给出的图像在几何轮廓、纹理位置和颜色上往往互相矛盾,直接投影到 UV atlas 会产生重影、断缝和局部漂移。作者输入一张带纹理图集的流形三角网格、稀疏生成视图与相机,将每个视图反投影为纹理颜色与置信度,再在表面域完成配准和融合。
核心技术与新意
流程分为四步:
- 以可见性、深度和观察角生成每视图的 back-projection 与 confidence;
- 先做跨视图颜色归一化,降低曝光和色偏差异;
- 解置信度感知的表面光流,将颜色与置信度沿网格表面 advect 到一致位置;
- 以置信度加权的梯度域优化缝合最终纹理。
关键工程点是用 quadrature-based finite-element integration 将 UV texel 采样和网格离散连接起来。它不像纯图像拼接那样把 UV 岛边界当成真实边界,也不要求每个输入视图先在像素域完全一致。
性能、限制与 TA 价值
在 RTX 2080 + i7-8700K 上,9/16 个生成视图的平均运行时间为 71/83 秒;33/55 个真实 RGB-D 视图上升到 842/1725 秒。方法没有做 view selection,输出 texel 会考虑全部反投影,因此视图数量增加时扩展性明显变差。
它适合把生成式概念视图、扫描补图或多相机重投影整合成一个一致的静态 appearance atlas;它不是 PBR 材质分解,不会自动得到可信的 BaseColor / Roughness / Normal,也无法保证生成内容在物理上正确。重复纹样、缺失覆盖和错误几何仍可能让光流落入错误对应。
UE5 落地点: 把它放在 DCC/烘焙阶段而非运行时:导出稳定 UV 与相机,生成或采集多视图,运行表面配准与缝合,再将结果作为人工审阅的 BaseColor 起点。先在一件 1–2K、8–16 视图的道具上比较“直接投影 / 仅 Poisson 缝合 / 完整方法”的 seam error 与人工修补时间。
阅读成本与建议: 约 30 分钟。优先看 Figure 1、Section 6 Method、7.5 Performance 与 Section 8 Limitations;要复现则直接从代码仓库的输入格式和示例脚本开始。
3. Honeycomb-Surfels:让表面基元自己承载局部结构
原文发布日期: 2026-10-28(按 arXiv UTC 首发时间换算上海日期)
来源: 论文 HTML · 项目页 · 官方代码(MIT)
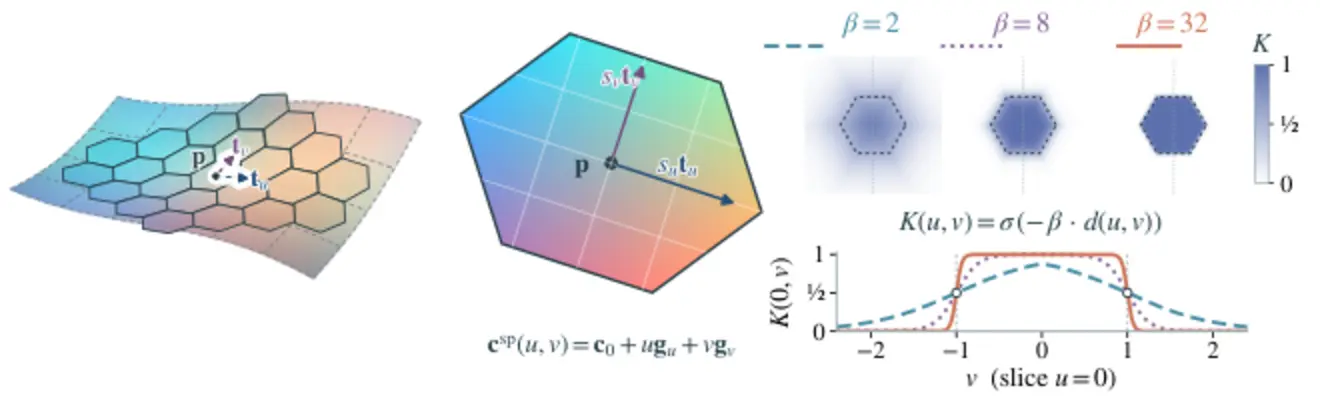
图:Kaushik、Paul、Yuille,Honeycomb-Surfels Figure 1,按 CC BY 4.0 原样转码与缩放;展示 Hexel 的局部坐标、软六边形支撑和一阶 RGB 颜色梯度。
发生了什么
Honeycomb-Surfels 提出 Hexel:一个平面六边形表面元,边界由可调锐度的软支撑函数控制,颜色不是每基元常量或仅靠球谐表达,而是在局部切平面坐标上使用一阶 RGB 梯度。六边形更接近平铺表面的形状,有限支撑也避免高斯长尾带来的大面积重叠和 overdraw。
新意、指标与限制
与 memory-matched 2DGS 相比,论文在多个数据集报告 PSNR 提升 4.53–7.38 dB;在同基元级比较中,训练峰值显存更低、渲染最高快 2.31 倍。DTU 15 个扫描的重建误差平均降低 28.9%,Tanks & Temples 平均 F1 为 34.38%,对照 2DGS 为 31.72%。代码直接以 MIT 许可证开放,复现门槛相对友好。
收益来自“更少的无效覆盖 + 每个基元能表达局部平滑颜色”,不是免费压缩。高频或无相关纹理需要更小 Hexel 或更复杂颜色模型;稀疏初始化会留下覆盖空洞;独立表面元不形成 watertight mesh;小投影尺寸和掠射角仍可能出现采样伪影。论文也明确承认并非所有数据集、所有指标都优于每个基线。
TA / 实时渲染价值: 这项工作值得当作 splat primitive 的设计课,而不只是“又一个 3DGS 变体”。如果自研点基渲染器,可把 kernel footprint、局部颜色阶数、基元数量和 overdraw 作为一个联合预算;若工作在 UE5,可先离线将 Hexel 输出转成面向 GPU 的结构化缓冲,做一个只读 raster pass,比较 2DGS 与 Hexel 的 primitives/pixel、tile occupancy、显存和远距离闪烁。
阅读成本与建议: 约 25–35 分钟。先看 Figure 1、Section 3、Tables 2–6 与 Limitations;只关心部署可再看 Appendix I.3 的压缩分析。
4. AMD FSR SDK 2.4:Vulkan 补齐超分与帧生成,UE 插件仍落后一小步
原文发布日期: 2026-10-28
来源: AMD GPUOpen 发布说明 · FSR SDK 主页与版本要求 · Khronos Vulkan 摘要
发生了什么
FSR SDK 2.4 将 ML Upscaling 4.1.2 扩展到 Radeon RX 6000,并首次覆盖部分 Ryzen 集显:Ryzen AI Max 使用完整 INT8 模型,受限 APU 使用轻量 INT8 模型。Vulkan 1.2 下,Upscaling 4.1.2、FSR 3.1.6、ML / 分析式 Frame Generation 与 Swapchain 路径达到 DX12 功能级,Intel PresentMon reporting 除外。
Vulkan 的 swapchain frame generation 会替换应用的 VkSwapchainKHR,并返回 swapchain 创建、acquire 与 present 的替代函数指针。SDK 延续 loader + signed effect DLL 架构;应用可以不固定 effect 版本,让驱动在未来提供更高版本,也可以显式 pin 版本以换取可复现性。
性能边界与 UE5 落地点
- ML Frame Generation 4.0.2 仍要求 RX 9000、Windows 11;其他硬件回退到分析式 3.1.6。
- Ray Regeneration 1.2.1 与 Radiance Caching 0.9.0 本期仍仅 DX12,不属于 Vulkan 对齐范围。
- 新 APU、Vulkan 与 Driver-Assisted Frame Pacing 需要 Adrenalin 26.10.1 或更高版本。
- 官方 UE5 插件当前仍使用 Upscaling 4.1.1 / Frame Generation 4.0.1,4.1.2 / 4.0.2 更新尚未发布。
因此本周最实用的工作不是立刻升级所有 UE 项目,而是把图形后端验收矩阵补全:DX12/Vulkan、ML/分析式 fallback、版本 pin/driver override、swapchain 重建、窗口模式切换、validation layer 与帧时间呈现分别测试。对于已有 Vulkan 分支的项目,先从 SDK sample 验证 loader、motion vectors、jitter、reactive mask 和 UI 合成顺序,再等待 UE 插件同步。
阅读成本与建议: 约 20 分钟。先读 GPUOpen 的 Vulkan、Supported GPUs、Requirements 三节;集成者再查 SDK 文档中的 Vulkan swapchain 与自动版本选择。
5. Codex 0.165:记忆、线程分叉与多工作树导航进入同一工作面
原文发布日期: 2026-10-28(GitHub 发布于 2026-10-27 20
UTC)来源: Codex 0.165.0 Release
发生了什么
0.165 为新 profile 默认启用 Memory v2,并允许导入外部 Agent 的记忆;app-server API 新增实验性的 attached thread forks;session picker 增加 repository filter,agent command center 按目录分组,方便在关联 worktree 间找回会话。版本还加入内建 GCP Vertex AI provider,并允许受支持模型在对话中切换 reasoning effort。
对长周期 TA 工程更重要的是故障语义:本地 future 被丢弃时会取消远端 MCP 请求;interrupt 或切换 Plan 后,排队的 Agent 消息不会重新唤醒工作;model-not-found 变成终止错误而非无意义重试;marketplace URL 校验也补上了可导致 Git 实际连接到不同主机的缺口。
实际价值与限制
一个 UE 插件或渲染实验常同时存在主工程、引擎 fork、性能分支与复现仓库。repository filter + 目录分组降低了“会话找错 worktree”的概率;attached fork 可把同一上下文分成“正确性”“GPU capture”“平台兼容”三个诊断支线;Memory v2 则适合保存可复用的构建、发布和验收约束。
但 attached thread forks 仍是实验 API;Memory v2 默认只影响新 profile,导入外部记忆也要审查过期约束与私密信息。发布说明没有给出 token、延迟或成功率基准,因此不能把“有记忆”直接等同于“更可靠”。
可立即尝试: 为一个渲染插件建立三分支诊断模板:共享问题陈述与已知证据,分别只允许修改 shader、渲染线程 C++、构建/平台配置;最终由主线程比较 diff、测试证据和 GPU capture,而不是让三个 Agent 同时写同一棵工作树。
阅读成本与建议: 约 10–15 分钟。优先看 New Features 与 Bug Fixes;做 Agent 平台集成再追 #56351、#56211/#56414、#56132 与 #56330。
优先阅读顺序
- DXR Clustered Geometry / PTLAS:会影响未来动态几何、Nanite、LOD、流送与光追数据布局,先建立正确心智模型。
- Texture Consolidation:最容易直接进入 TA/DCC 纹理流程,并且已有 BSD 代码可跑。
- AMD FSR SDK 2.4:跨 API 或多硬件项目应立即更新验证矩阵;纯 DX12 单平台项目可稍后看。
- Honeycomb-Surfels:适合自研表面基元、点渲染或 Neural Rendering 团队;常规 UE 内容团队先理解设计取舍即可。
- Codex 0.165:工具链负责人优先;不维护多仓库、多 worktree 的个人工作流可快速浏览发布说明。
本周动手实验
做一次“局部可复用性”审计,而不是先接预览 API。
选一个包含 Nanite 静态场景、一个骨骼角色与可流送 cell 的 UE5 测试关卡,离线导出以下指标:
- 以 128/256 三角形聚类后的簇数量、边界顶点重复率与材质跨度;
- 相邻 LOD 间可共享簇比例;
- 以 World Partition cell 分区后的实例数、AABB 重叠率与每帧变化分区数;
- 把高频移动对象放入全局分区前后的重建字节数与遍历重叠估计;
- 预算两套 scratch:平均帧与最坏流送/动画帧。
这项实验不依赖厂商预览驱动,却能直接回答资产和场景是否具备 Clustered Geometry / PTLAS 所需的局部性。若未来接入 DXR 1.722,再用相同数据对照 AS build time、trace time、AS bytes、scratch bytes 与最终帧时间,避免只看单一 FPS。
趋势观察
实时渲染正在从“选择一种更强算法”转向“设计可以持续复用的中间状态”:CLAS/PTLAS 复用几何与空间局部,Texture Consolidation 复用表面对应,Hexel 把局部外观直接塞进基元。性能优势越来越取决于数据分块、更新频率和同步边界,而不只取决于 shader 本身。
跨 API 的神经渲染功能也开始成熟,但产品集成不会自动同步:FSR SDK、驱动、Vulkan swapchain 和 UE 插件分别有自己的版本节奏。Agent 工具链出现相同规律——Memory 与 thread fork 带来长期状态后,取消、分支隔离和来源审查反而成为可靠性的核心。
来源与核验
- 时间窗口按 Asia/Shanghai 自然日计算:新闻为 2026-10-24 至 2026-10-30;深读与补充允许回溯至 2026-10-17。本期没有使用补充项。
- 论文发布日期以 arXiv v1 的 UTC 时间换算上海日期;代码许可证分别从仓库
LICENSE核验:Texture Consolidation 为 BSD-3-Clause,Hexels 为 MIT。Honeycomb-Surfels 原文标注 CC BY 4.0,文中 Figure 1 仅做等比缩放和 WebP 转码并保留署名与链接。 - DXR 的性能数据来自 Microsoft 官方极端样例,不按通用游戏增益外推;硬件支持与预览条件按 2026-10-28 官方文章记录。
- FSR 的版本、Vulkan 范围、硬件要求和 UE 插件版本以 AMD GPUOpen 为准,并以 Khronos 公告交叉核对。
- Codex 0.165.0 的 GitHub
published_at为 2026-10-27 20:09 UTC,对应上海 2026-10-28。 - 已固定检查 Unreal Engine 官方 YouTube 的本周上传;没有核验到落在本期窗口且达到入选阈值的新技术内容。搜索命中的 Mesh Terrain 等讲座实际发布于 2026 年 7 月,未纳入本期。
- 已与 2026-W40 至 W43 的栏目主题去重;本期不另发 Weekend Long Read。