本周速览
实时渲染里最难消失的一类成本,不是平均工作量,而是少数特别重的 tile、像素、材质区域或几何段拖住整帧。本期五项内容从不同角度处理这种不均匀性:重 tile 要被提前调度并拆块;皮肤参数应按区域拟合到真实 shader;体积光照尝试从便宜特征直接解码最终结果;曲线基元让细长结构不再靠大量散点勉强表示;UE 5.9 MegaJam Preview 则把 Agent 与 WebGPU 目标扩进编辑器,但仍带有明确的实验性边界。
- 深读:3DGS 的 SM 级负载均衡。 先用最长处理时间优先(LPT)把重 tile 提前,再把极重 tile 沿深度分块并利用 alpha 可组合性归并,个别帧的 alpha blending 最多加速 5.64×。
- UE 5.9 MegaJam Preview。 Unreal MCP、编辑器内 Agent、扩展 Python API 与 WebAssembly/WebGPU 目标集中出现;它是短 QA 的预览构建,不应直接升级生产项目。
- 可微皮肤数字化。 不再先反演难以映射到游戏 shader 的光学系数,而是用四张受控照片直接拟合 Burley SSSS 的有效散射距离与区域纹理。
- HaloRT。 用主光线特征和少量环境采样直接推断云的多次散射,省掉推理时的 path-traced radiance buffer,在 RTX 5090 的 512² 测试中平均 10.66 ms。
- Spaghetti Splatting。 将曲线 Dirac 质量与 Gaussian/Beta kernel 卷积,得到可微、可抗锯齿、可连接并能进入物理模拟的曲线 primitive。
收集窗口:2026-11-07 至 2026-11-13(上海自然日);深读与补充最多回溯至 2026-11-01。本期五项均在主窗口内发布,不另发 Weekend Long Read。
精选新闻
1. 深读|3DGS 不只要减少总工作量,还要消灭最后一个重 tile
原文发布日期: 2026-11-09(arXiv v1)
来源: Mitigating SM-Level Load Imbalance in 3D Gaussian Splatting on GPUs
发生了什么
Junha Ryu 与 Hoi-Jun Yoo 把 3D Gaussian Splatting 的 alpha blending 延迟拆成一个更具体的问题:传统 tile rasterizer 通常把每个 16 × 16 tile 交给一个 256-thread CTA,但不同 tile 覆盖的 Gaussian 数量差异巨大。作者在标准场景中测到最重与最轻 tile 的 Gaussian 数量相差 55–605×,大场景可超过 6100×。多数 SM 已经完成工作时,少量重 CTA 仍占着最后几个 SM,形成明显的 execution tail。
这解释了为什么“减少平均 Gaussian 数”并不保证帧时间等比例下降:GPU 完成时间由最后一个 CTA 决定。方法因此分成两层——先改变 tile 的启动顺序,再改变极重 tile 的粒度。
核心技术与新意
第一层是 persistent kernel + LPT 调度。作者按每个 tile 的 Gaussian 数估算工作量,用 radix sort 得到从重到轻的 tile 索引;固定数量的常驻 CTA 从全局计数器取任务,让最重 tile 尽早占用全部 SM。这里不重新排序 Gaussian,只排序 tile id,调度开销低于 alpha blending 时间的 1%。LPT 不能缩短单个极重 tile,却能把它从队尾移到队首,让轻任务填补剩余空洞。
第二层是 depth-contiguous chunking。对已经按深度排序的 Gaussian 序列,任意分界点都满足 front-to-back alpha 的可组合关系:
C = C_front + T_front × C_back
因此一个重 tile 可以沿深度切成 2、4、8 或 16 个连续 chunk,各自由独立 CTA 混合,最后按深度顺序归并颜色与透射率。它不是把像素任意拆开,而是保留 alpha compositing 的结合结构,避免改变可见性次序。
难点是 early termination。若前段已经把透射率压到阈值以下,后段继续工作会浪费成本。作者用全局 saturation flag 与 atomicMin 记录最早饱和位置;后续 chunk 每处理 256 个 Gaussian 才检查一次,以减少原子与同步频率。因为 front-to-back 透射率单调下降,停止点可以安全传播到更深的 chunk。
最后,系统不是无条件拆分。每帧用轻量 cost model 在重 tile 数量 h 与 chunk 数 k ∈ {2, 4, 8, 16} 间搜索;只有估计比单纯 LPT 至少快 10% 才启用 chunking。普通 tile 与 chunk CTA 放在不同 CUDA stream 中,避免重 tile 拆分反而挤压常规任务。
性能、限制与数字应如何解读
论文在 48 SM 的 NVIDIA GB10 与 84 SM 的 RTX A6000 上测试。标准 3DGS benchmark 的 alpha blending 平均加速 1.12×,驾驶场景平均 1.23×,单帧最高 3.20×;对更偏斜的 Hierarchical 3DGS,平均达到 2.93×、单帧最高 5.64×。数值差异保持很小:相对原始输出的 PSNR 高于 76 dB,最大差异约 0.0015 dB PSNR、2.4e-5 SSIM 和 7e-5 LPIPS。
更值得注意的是硬件趋势:驾驶场景在 A6000 上平均 1.45×,GB10 上为 1.32×。SM 越多,轻 tile 越快被清空,单个重 tile 留下的相对尾巴越明显;这不是“新 GPU 自动解决负载不均”,而可能是更多并行度让长尾更刺眼。
限制也很清楚:
- 方法只优化推理阶段的 alpha blending,不覆盖训练、排序和预处理全链路。
- tile Gaussian 数只是成本代理,无法完全预测 early termination、覆盖率与缓存行为。
- 平衡场景只有约 1.03–1.10×,策略多数时候不会拆块。
- cost model 使用固定常数,不同 GPU、kernel 版本和场景分布最好重新标定。
- chunking 需要额外状态、归并与原子操作;如果没有极重 tile,这些成本不值得付。
对 TA / UE5 的实际价值
这篇论文的价值不局限于 3DGS。透明粒子、屏幕空间模糊、体积雾、Virtual Texture 页处理、clustered lighting 与任何“一 tile/一 workgroup”的 Compute Shader,都可能出现同样的 SM tail。TA 做性能排查时,应在平均 dispatch time 之外记录:每 tile 工作量直方图、max / mean、尾部百分位、最后活跃 wave 数和 SM occupancy 随时间的变化。
UE5 落地点: 先做一个不依赖 3DGS 的 RDG Compute 实验。生成偏斜程度可控的 tile workload,比较三版实现:固定 tile → group、persistent LPT、LPT + 仅重 tile 分块。输出总工作量相同条件下的 GPU 时间、P95/P99 tile cost、最后 10% 时间的活跃 wave 数,以及拆块/归并开销。若 RenderDoc 或平台 profiler 显示后半段只剩少数 workgroup,这套调度思路才有迁移价值。
阅读成本与建议: 40–55 分钟。先看 Figures 3–5 理解长尾,再读 Sections 4.1–4.4 的 persistent scheduling、chunking、saturation signaling 与策略选择;最后看 Figures 12–15 和 Limitations,重点比较不同 SM 数量与 workload skew,而不是只记最高加速比。
2. UE 5.9 MegaJam Preview:Agent 与 WebGPU 进入编辑器,但它仍是实验场
原文发布日期: 2026-11-09
来源: Unreal Engine 5.9 MegaJam Preview 公告 · Lighting and Rendering Updates
发生了什么
Epic 为 AI MegaJam 发布 UE 5.9 MegaJam Preview,并明确说明这不是常规 Preview:它包含 UE5 Main 的积累内容,也包含约一周内借助 Agent 工作流完成的代码;QA 时间很短,部分 Agent 生成代码仍在清理,Web renderer 也处于原型阶段。最稳妥的定位是“可用于 Jam 和隔离测试的技术快照”,不是即将量产的稳定升级包。
本次最显著的工程变化是 Unreal MCP 自动启动并扩充工具集,覆盖渲染、Source Control、Profiling、Debugging、Gameplay Test、Geometry、Audio、UI 与 Level;Unreal Assistant 可在编辑器内连接 Claude Code、Codex、Cursor 和 OpenCode。Python API 也扩到 Audio、MetaSounds、Modeling、Physics、Niagara、Materials、PCG、Networking 和 UI。实验性的 Unreal Canvas 用于让 Agent 生成和编辑可视内容。
另一条重要线是 WebAssembly + WebGPU 浏览器目标。当前使用 Mobile Renderer,需要源码构建与 C++ 项目,Chrome 支持最好。它提供了真正的引擎内 Web target 方向,但公告列出的边界足以说明它还不适合承诺生产交付。
核心技术、限制与渲染信号
Web 目标目前受 2 GB Wasm 内存上限约束;强制多线程可能增加内存问题,官方默认建议单线程 Shipping。旧于 iPhone 15 Pro 的移动设备缺少 BC/DXT 支持,需要额外 cook ASTC 并使用 -WasmAddTextureSet。实验性的 desktop tier 在 AMD 浏览器 GPU 上可能崩溃;Bink 未支持;-NoCleanStage 的增量 staging 还可能把过期内容带入包体。
移动渲染同样有具体坑:Mobile Forward 下,靠近 Reflection Capture 的 metallic/glossy 材质可能变黑;公告建议启用 Clustered Reflections,Mobile Deferred 不受该问题影响。MCP server 虽默认开启,toolset plugin 可能未全开,需要启用 AllToolsets 或在 .uproject 中显式配置。
渲染路线图同时提到 Lumen World Cache、AVBOIT 顺序无关透明与更快的 Nanite culling,但页面状态仍是路线图信息,没有可用于质量或性能判断的实现数据。本期只把它们当作方向信号,不写成 UE 5.9 已可用功能。
对 TA / UE5 的实际价值
对 TA 团队,最值得测试的不是“让 Agent 自动做完整关卡”,而是给 Agent 一个可验证的窄工具面:例如创建材质实例、枚举超预算纹理、切换 Niagara debug、运行固定视角 GPU capture、读取 shader compile error。每个工具都应有前置状态、可审查的参数、幂等性、撤销路径和输出证据。
WebGPU 目标则应先做兼容性资产清单:纹理压缩格式、内存峰值、shader model、移动/桌面 renderer 差异、视频与音频依赖、cook 增量正确性。不要在主分支直接转换项目;复制一份最小 C++ sample,先用 Chrome 跑通基础材质、Nanite 替代路径、透明、反射与输入。
阅读成本与建议: 15–25 分钟。先读公告的 Known Issues 与 Web Renderer Instructions,再看 MCP/toolset 配置;渲染路线图只用于建立观察列表。生产项目至少应等待正式 Preview/Release、完整 release notes 和目标平台验证。
3. 直接拟合游戏 shader:轻量可微皮肤数字化
原文发布日期: 2026-11-10(arXiv v1)
来源: A Lightweight Differentiable Method for Real-Time Skin Rendering and Digitization
发生了什么
Mario Marquez-Balduque、Carlos Rodríguez-Pardo 与 Jorge Lopez-Moreno 提出一套单相机、单投影仪的皮肤采集与可微拟合流程。传统逆渲染常估计物理意义更强的吸收/散射系数,但游戏引擎里的 screen-space SSS 往往只暴露经过缩放和经验化的“散射距离”参数,两者并不能直接对应。作者因此反过来:对目标实时 shader 本身做可微优化,输出可以直接进入该 shader 的有效参数。
每个皮肤区域只拍四张图:环境黑场、竖条纹、反相条纹与全白。投影仪距离约 20 cm、向上倾斜 30°,DSLR 在后方约 50 cm、近共轴;受控暗室用于减少环境光。条纹/反条纹差分经过 Otsu 阈值与形态学处理,生成两个不同用途的 mask:硬二值 loss mask 只让阴影中的多次散射主导优化;另一个经 11 × 11 Gaussian 平滑,用于最终渲染混合,避免硬边伪影。
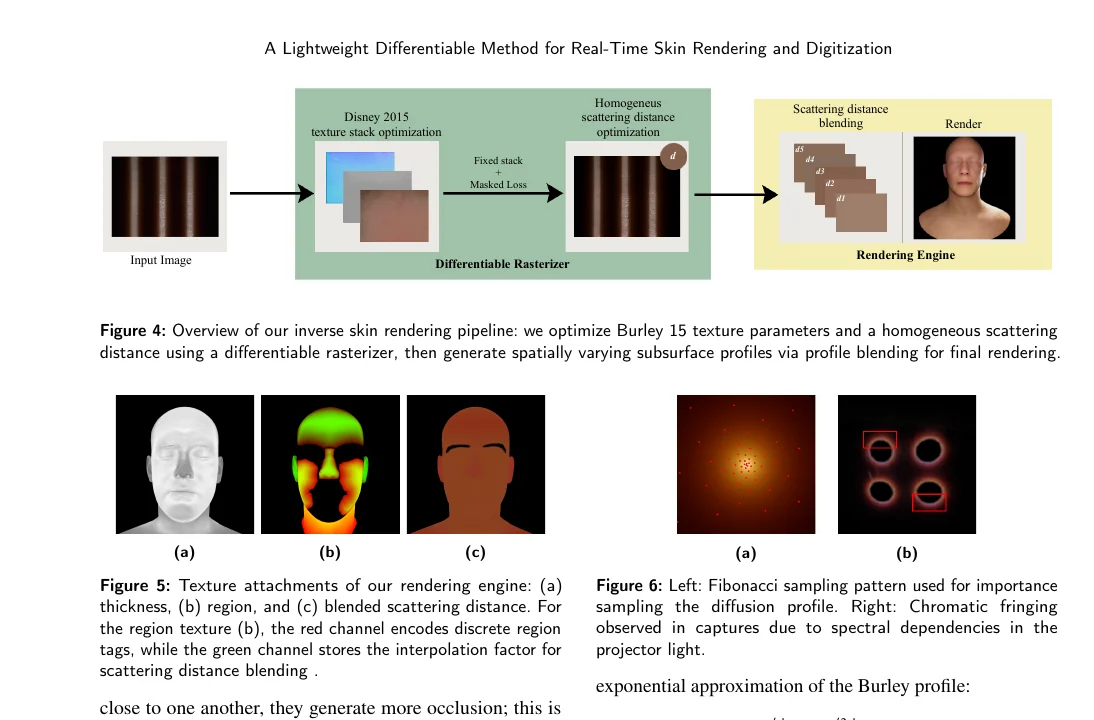
原论文 Figures 4–6:从受控条纹输入,经 Burley 2015 texture stack 与 homogeneous scattering distance 优化,生成厚度、区域与混合散射距离纹理。图像裁切与 WebP 转换;© 论文作者,按 CC BY 4.0 使用。
核心技术与新意
渲染器使用 Burley 2015 normalized diffusion 的双指数近似,并用 Fibonacci pattern 与随机旋转 jitter 对径向分布重要性采样。与常见 2D 屏幕半径不同,方法从深度重建采样点的 view-space 位置,再计算真实 3D 欧氏距离,使散射 profile 对相机距离与 FOV 更稳定。厚度由反法线 SSAO 近似;可选的 anatomical region map 用红通道存离散区域、绿通道存插值权重,把多个均匀区域的拟合结果混成连续散射图。
论文按 UE5 风格把归一化纹理 [0, 1] 映射到 [0, 1.0] cm,再以 0.01 转到世界空间米制。这里的 d = 1/s 是实时 shader 的有效尺度,而不是可跨模型复用的内在散射系数 σs。这是方法最重要也最容易误读的边界:它追求“目标 shader 中可用”,不是完整恢复表皮/真皮分层光学。
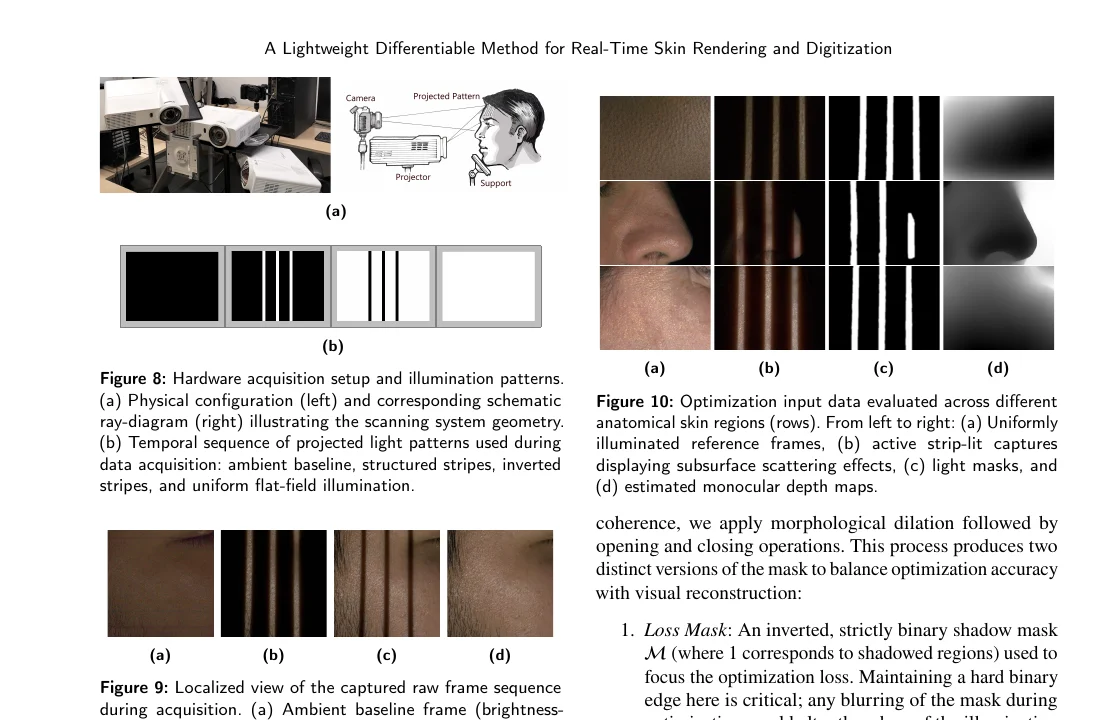
原论文 Figures 8–10:单投影仪/单相机装置、黑场/条纹/反条纹/全白序列,以及参考帧、散射条纹、mask 和单目深度输入。图像裁切与 WebP 转换;© 论文作者,按 CC BY 4.0 使用。
性能、限制与 TA 价值
PyTorch 张量化 SSSS 在 RTX 4070 Ti 12 GB 上处理一个 480 × 360 patch 约需 198.4 秒,峰值显存 9.4 GB;这是离线资产拟合,不是实时扫描。实验覆盖 45 名、跨 Monk Skin Tone Scale 的受试者,但仍依赖受控光照、局部皮肤 patch、单目深度与固定几何/曝光设置。
屏幕空间方法看不到屏外贡献,单目深度与反法线 SSAO 厚度都只是近似;局部拟合也不等于全脸连续的分层皮肤模型。换 shader、世界单位或 profile 定义后,已拟合 d 未必能直接迁移。
对 TA 最有用的观念是:如果最终交付目标是 UE Subsurface Profile 或自研 SSSS,就应让 inverse rendering 优化器使用同一段扩散核、同一单位约定、同一厚度近似与相同 tone/exposure 边界。否则“物理参数更漂亮”也可能在真正的材质里失真。
UE5 落地点: 不必先复现采集硬件。选 3–5 个受控皮肤 patch,用现有 UE shader 离线扫 d、BaseColor 与 Roughness,建立可微或有限差分的最小拟合;输出 shader 参数与固定灯光下的差异,而不是先换算成 σs/σa。随后改变相机距离和 FOV,验证 view-space 3D 距离是否比 2D radius 更稳定。
阅读成本与建议: 30–45 分钟。优先看 Figures 4–6、8–10,以及 Sections 3.2、4.1、4.2;性能与边界看实验设置和 Limitations。实现者应特别核对散射距离的厘米/米换算和两个 mask 的不同职责。
4. HaloRT:不去噪路径样本,直接从便宜特征解码体积光传输
原文发布日期: 2026-11-09(arXiv v1)
来源: Real-Time Volumetric Light Transport Inference without a Path
发生了什么
Ludwic Leonard 与 Ruediger Westermann 提出 HaloRT:推理时不输入 path-traced radiance,而从主光线上的低成本特征直接重建云在方向光与环境光下的最终像素辐射亮度。输入包括 optical depth、多尺度 interaction/crossing depth、朝主光的 transmittance、期望首次交互位置的环境光采样,以及 Henyey–Greenstein 各向异性与 single-scattering albedo。
这与常规 neural denoiser 的区别不是“把 4 spp 降到更少”,而是取消 radiance sample。绝大多数特征确定性计算,环境光只用 8 个重要性采样;网络学习的是“这些近似充分特征到完整多次散射”的映射。
核心技术与新意
渲染端用 Vulkan,直接将 device memory 导出给 CUDA 网络,避免 host 同步。主光线采用 exhaustive ray marching,并用 coarse majorant grid 的 DDA 跳过空区;一次 traversal 求 optical depth,第二次同时求四个密度尺度 ×4, ×1, ×0.25, ×0.1 的 crossing。环境方向通过基于 HDR luminance 的 quadtree 重要性采样。
解码器是六次下采样的 U-Net,bottleneck 为 64 channels,在四个阶段和 bottleneck 使用局部 Halo attention。全分辨率 attention 的二次内存/时间代价被避免,而 bottleneck 的 receptive field 仍覆盖整图。光传输对入射光线性、颜色通道在无光谱耦合时独立,因此作者把环境光与方向光拆成两个单通道 decoder,并跨 RGB 复用权重;这比让一个大网络自己学习线性与通道独立更省容量。
性能、限制与 TA 价值
在 RTX 5090、15 个未参与训练的 cloud、200 张 512 × 512 测试图上,HaloRT 平均 10.66 ± 0.52 ms,PSNR 42.79 dB、SSIM 0.9874、LPIPS 0.0420。使用同一特征但保留 4 spp radiance 的 DenoiserX 为 24.76 ± 9.98 ms、PSNR 44.23 dB、LPIPS 0.0517。HaloRT 的像素 PSNR 略低,但感知指标、稳定性与时间更好;RMS-SD 为 0.00070,约为 DenoiserX 的 1/4、普通 denoiser 的 1/9。
网络本身在 512² 只约 1.56 ms,但表中 10.66 ms 包含特征生成;到 2048²,单个 HaloRT pass 约 10.5 ms,而且每个照明分量、每个颜色通道都需一遍,不能把“单 pass”误读为完整 4K 彩色帧。训练集包含 500 个 Cloudy Project 体积、1000 个合成 HDR-like environment,共 22,000 个 4096 spp 参考实例。
范围限制很重:只训练 cloud-like medium;HG phase function、非发光介质、一个体积、远距离环境光与一个主方向光;不处理局部灯、介质内/周围表面和 emission。其精度依赖训练分布覆盖,“特征近似充分”并非物理定理。论文也指出强方向光与普通环境光下,离开主光线邻域的结构会带来特征无法显式表达的信息。
对实时渲染的启发是:神经近似未必必须消费噪声 radiance;如果能设计结构化、稳定、廉价且与 transport 强相关的 buffer,网络可以直接解码结果。对 UE5,可先把它当离线研究:导出 Volumetric Cloud 的 optical depth、first-hit depth、多尺度 density crossing、sun transmittance 和 phase 参数,与 path-traced reference 训练小型 decoder;先验证换天气、换云体积、换太阳角度时是否泛化,再谈 runtime plugin。
阅读成本与建议: 35–50 分钟。先看 Figure 1 与 Sections 3.3–3.5 的特征充分性与结构化 decoder,再看 Tables 1–2、Figures 5–7 和 Section 6。实现者重点核对“网络时间”和“完整管线时间”不是同一个数字。
5. Spaghetti Splatting:把细长结构变成真正可连接的可微曲线
原文发布日期: 2026-11-09(arXiv v1)
来源: Spaghetti Splatting: Differentiating Curvilinear Dirac Masses via Convolution
发生了什么
George Shramko 等人把 3DGS 的“Dirac primitive 与低频 kernel 卷积”从点推广到曲线。曲线用 polyline 近似,每条 segment 与 anisotropic Gaussian 或 Beta kernel 卷积;segment 越短,其卷积收敛到连续曲线。点可以视为零长度曲线,因此这个表示在形式上严格包含 3DGS。
相比用很多 Gaussian 点拼头发、细枝、线缆或草叶,输出是有连接关系的长 strand,更接近 DCC 中 artist-facing 的 curve,也可直接进入 shading、groom 与物理模拟。它仍通过体渲染优化多视图图像,而不是要求先有干净的曲线监督。
核心技术与新意
Gaussian-convolved segment 沿 camera ray 的积分有包含 erf 的闭式解。作者为每段线性化相机投影以获得快速 EWA-style splatting,同时让 Beta kernel 也能工作。相邻 segment 不能各自简单堆 alpha,否则 joint 会重复计密度;论文推导的 compositing 使连接段可以独立渲染,并在 segment subdivision 后保持图像结果不变。
优化沿用 3DGS-MCMC 的 population control,但针对曲线做两种重采样:长段从 midpoint 一分为二,短段 clone 到需要容量的位置;低 opacity 段被 relocation。邻近 polyline endpoint 会被 attraction loss 拉近并合并。消融显示,关闭 merging 对 PSNR 几乎无影响,却把平均 connected component size 从 3.50 降到 1.00——这提醒我们,图像指标不能衡量输出是否真能进入 groom/physics 工作流。
性能、限制与 TA 价值
在 Mip-NeRF 360 上,Gaussian kernel 版本为 28.56 dB / 177 FPS,接近 3DGS-MCMC + Spherical Voronoi 的 28.39 dB / 198 FPS;Beta 版本为 28.78 dB / 129 FPS。在线状 Fuzzy 数据上,Gaussian 版本达到 35.03 dB / 415 FPS。对 GeomHair 与一组 curly-hair 模型,方法平均 32.25 dB、SSIM 0.940、LPIPS 0.043,2/3/4 mm 的 strand F1 为 61.2/80.3/88.9,明显高于 Gaussian Haircut 的 46.9/63.5/72.7。
高频颜色仍迫使曲线拆成很多短 segment,几何会为纹理服务而变碎;作者尚未在端点间插值 kernel,不能自然覆盖锥体、梯形或曲面;真实头发仍困难,且“自动恢复正确拓扑”需要更多验证。论文承诺完整开源,但本期核验时仍应以论文方法与 CC0 文本/图示为准,不预设代码已经可下载。
对 TA 的实际价值在于重新审视资产表示:若最终资产本来就是 groom strand、藤蔓、线缆、道路或枝条,点云/3DGS 可能是错误的中间语言。可先在 DCC 做一个简单对比:对同一束细曲线分别用点 splat 与 curve segment 拟合,测试跨距离抗锯齿、连接组件长度、物理约束数量、LOD 后拓扑稳定性与导入 UE Groom/Geometry Cache 的转换成本。
阅读成本与建议: 35–50 分钟。先看 Figures 2–3 和 Sections 3.2–3.5,理解 primitive/kernel 两条推广轴;再看 Figures 7–8 与 ablation。做资产管线者应把 connected component size 与 hair F1 放在 PSNR 前面。
优先阅读顺序
| 优先级 | 内容 | 阅读成本 | 为什么先看 |
|---|---|---|---|
| 1 | 3DGS 的 SM 级负载均衡 | 40–55 分钟 | 本期深读;把平均成本、调度顺序、任务粒度与 SM 长尾连成完整工程问题。 |
| 2 | 可微皮肤数字化 | 30–45 分钟 | 直接连接采集、PBR/SSS 参数与 UE 单位约定,最容易转成材质实验。 |
| 3 | UE 5.9 MegaJam Preview | 15–25 分钟 | 影响近期 UE 工具链与 Web target 判断,但必须先读完已知限制。 |
| 4 | HaloRT | 35–50 分钟 | 展示“特征解码替代 radiance denoising”的清晰范式,适合体积云研发。 |
| 5 | Spaghetti Splatting | 35–50 分钟 | 对 Groom、曲线资产与可微几何很有潜力,当前更偏研究与管线前瞻。 |
本周动手实验
做一次 tile workload 长尾可视化与 LPT 调度对比。 不必先实现 3DGS,只需一个可控的 Compute Shader 测试床。
- 生成 256–4096 个 tile,每 tile 循环次数来自均匀分布、对数正态分布和“少量超重 tile”三种 workload。
- 版本 A 使用固定
tile id → workgroup;版本 B 预先按估算工作量降序,persistent group 从原子计数器取下一项。 - 记录总操作数、GPU 时间、P50/P95/P99 tile cost、
max / mean与最后 10% 执行时间的活跃 workgroup。 - 再给最重的 1%、5%、10% tile 做 2/4/8 段切分,加入归并成本;找出从“拆分有利”变成“调度开销更贵”的阈值。
- 最后故意让估算值与真实工作量存在 10%、30%、50% 误差,检查 LPT 对错误 cost proxy 的敏感度。
这个实验的目标不是复制论文最高加速,而是验证你的目标 GPU 和实际 dispatch 是否存在 execution tail。只有 profiler 显示后半段 SM 明显闲置,才值得把持久化调度与分块引入生产 shader。
趋势观察
本周的共同趋势是“表示和调度开始适应内容的不均匀性”。3DGS 按重 tile 重排执行,皮肤按区域拟合 shader-native 参数,曲线 primitive 让细长几何不再由散点代理;优化对象从平均场景转向最难的局部结构。
Neural Rendering 也在从“稀疏 radiance + denoiser”向“结构化特征 + decoder”分叉。HaloRT 说明,若输入 buffer 足够贴近 transport,推理不一定需要 path sample;但它对训练分布和照明模型的依赖同样更强,工程重点会落在 feature contract 与 out-of-distribution 检测。
UE 的 Agent 化则进入“工具面设计”阶段:支持更多模型不是终点,真正决定可靠性的会是可验证工具、项目状态、撤销与平台边界。MegaJam Preview 很有方向感,也正因为已知限制写得具体,才更适合作为隔离实验而非生产承诺。
来源与核验
- 本期窗口与发布日期按上海自然日核对;五项原文均发布于 2026-11-09 至 2026-11-10,没有使用未来内容。
- 论文数据以 arXiv v1 正文、实验表格与限制章节为准;没有把摘要中的“real-time”“state of the art”直接当作跨硬件结论。
- UE 5.9 条目以 Epic 官方论坛公告与官方路线图为准,并保留 Preview、Experimental、Known Issues 与路线图状态的区别。
- 固定检查了 Unreal Engine 官方 YouTube 频道 在 2026-11-07 至 2026-11-13 的上传;没有发现落在本期窗口内且足够技术向的新视频,因此未为固定检查项凑数。
- 皮肤论文在 arXiv 标注为 CC BY 4.0;正文两张图仅做页面裁切与 WebP 转换,保留 Figure 编号、作者归属、来源与许可证。其他论文未在本期复制原图。
- 封面为本期生成图,表现重 tile 被拆成有序 chunk 并分配到并行 GPU lane;不使用第三方品牌元素。