Agent 可以很快交付一次修改,但一个项目是否值得继续投入,要看下一次修改:能否找到正确位置,理解已有约束,安全地改变行为,并拿出可信的验证结果。
本文把“整洁”理解为降低理解、修改和验证的成本,把“可持续能力”理解为经历多轮修改后,系统仍保有这些能力。下面先给出覆盖整场访谈议题的时间导航,再对照 OpenAI 的公开资料,最后落到一套适合个人开发者的工作方式。
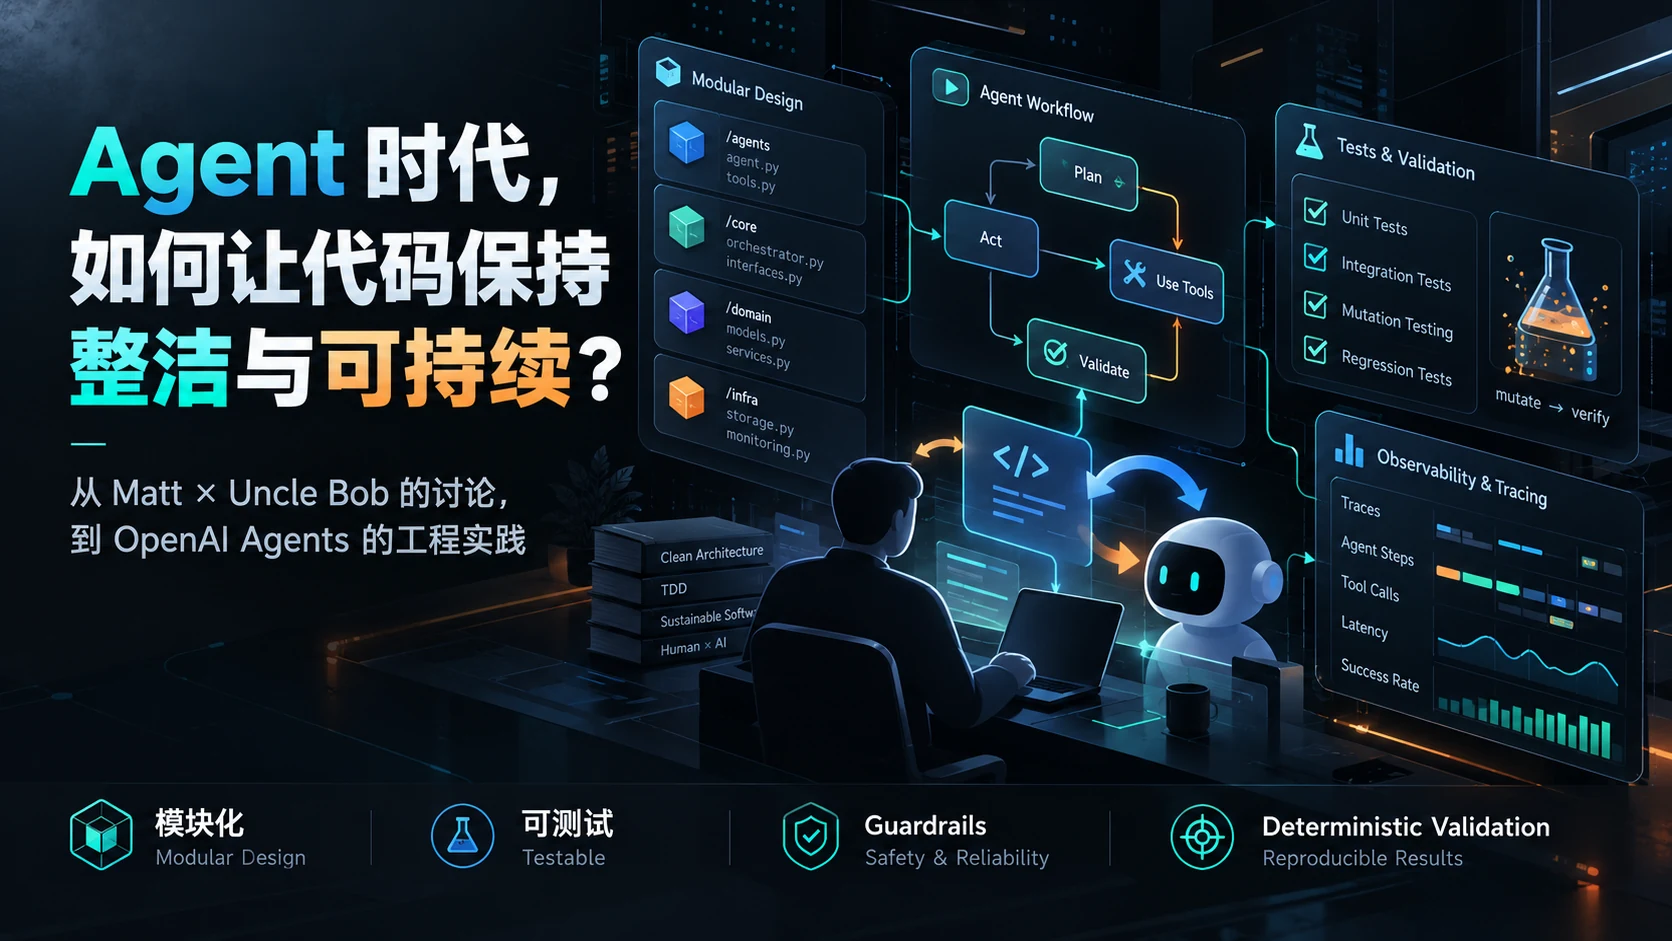
封面沿用此前生成的概念插画;正文流程图为本文绘制的工程建议,均非受访者或论文的原图。
先看全貌:维护代码需要四项责任
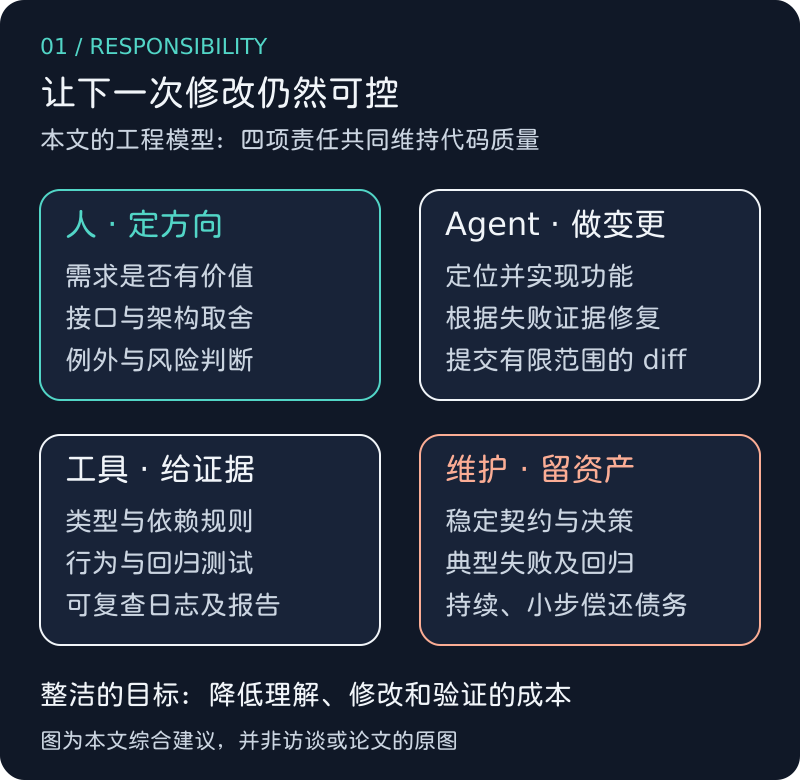
这四项责任可以由很少的人和工具承担。个人项目通常只需要一个执行 Agent、已有检查命令和几份持续维护的文档。关键是每项责任都有实际产出。
| 责任 | 需要留下什么 |
|---|---|
| 确定方向 | 可观察的预期行为、关键取舍 |
| 完成变更 | 范围明确的 diff、可复现步骤 |
| 产生证据 | 对应当前提交的命令、结果与日志 |
| 持续维护 | 稳定契约、回归用例、待偿还的技术债 |
Matt × Uncle Bob:整场访谈的思想导航
资料来自 完整节目及 公开转录。转录未可靠区分说话人,以下按问答语境整理概要,非逐字译稿。
| 时间 | 讨论中心 |
|---|---|
00:00–04:07 | 浴袍故事、编程经历、《Clean Code》。 |
04:07–09:56 | Bob 转向 CRAP 与变异测试。 |
09:56–12:12 | 脏代码让 Agent 反复修坏。 |
12:12–17:40 | 精简指令、确定性检查及成本。 |
17:40–23:08 | Matt 质疑复杂编排;Bob 用规格→实现→清理→加固→QA。 |
23:08–25:23 | Matt 强调会话轨迹;Bob 赞同聚焦。 |
25:23–29:41 | 测试之外,还需查看和约束依赖。 |
29:41–31:24 | 深模块:小接口隐藏复杂度。 |
31:24–35:42 | 调整阈值,不照搬人的 TDD 节奏。 |
35:42–42:21 | 小步反馈,避免过重前期规划。 |
42:21–45:12 | 规格保存、成品参考、阅读不对称。 |
45:12–52:59 | 新人需编码、经历失败、学习设计。 |
52:59–56:41 | 基本功组织复杂度;结尾回到书。 |
来源:节目转录及对应时间段。
接下来讨论的是本文对工程实践的推导。把这些议题放进真实项目,最值得追问的是:检查的标准由谁定义,检查是否有效,以及几轮修改后系统是否更容易理解?
OpenAI 的资料:工程经验与研究各回答什么
这些资料的证据层级不同。Ryan Lopopolo 的文章是团队工程实验;SWE-Lancer 是任务评估研究;评估审计研究的是测试能否提供可靠信号。它们不能合并成“已经证明 Agent 可以长期无人维护”。
| 资料 | 可以支持的判断 | 尚不能据此断言 |
|---|---|---|
| Ryan Lopopolo:Harness engineering,2026-02-11 | 仓库知识、依赖约束、可观测性与持续清理,有助于 Agent 工作 | 全部由 Agent 生成的系统能保持多年架构一致性 |
| Miserendino 等:SWE-Lancer,2025-02-18 | 真实工程任务需要端到端验收,测试本身需审阅 | 当时模型表现等同于今天的能力 |
| OpenAI:Separating signal from noise,2026-07-08 | 测试过严、需求缺失、覆盖不足与误导性描述会扭曲评估 | 一份通过的测试报告就能证明需求完整实现 |
| OpenAI:Evaluating chain-of-thought monitorability,2025-12-18 | 监控也有盲点,需要评估其有效性 | Agent 的最终解释能充当可靠的行为审计 |
Lopopolo 的团队把简短的 AGENTS.md 用作导航,把深入知识放在仓库文档中;依赖规则由工具检查,质量偏差通过小范围清理持续纠正。他们也明确承认,多年后的架构一致性仍是未知问题。工程实验原文
这里有一个值得保留的取舍:临时探索计划可以过期,已生效的契约和重要决策需要有可追溯的版本。团队工程经验也允许小改动使用轻量计划,复杂工作留下执行记录。本文据此建议按知识寿命管理文档,而不是要求所有任务采用同样重的规格流程。
第一步:把质量要求变成有出口的反馈循环
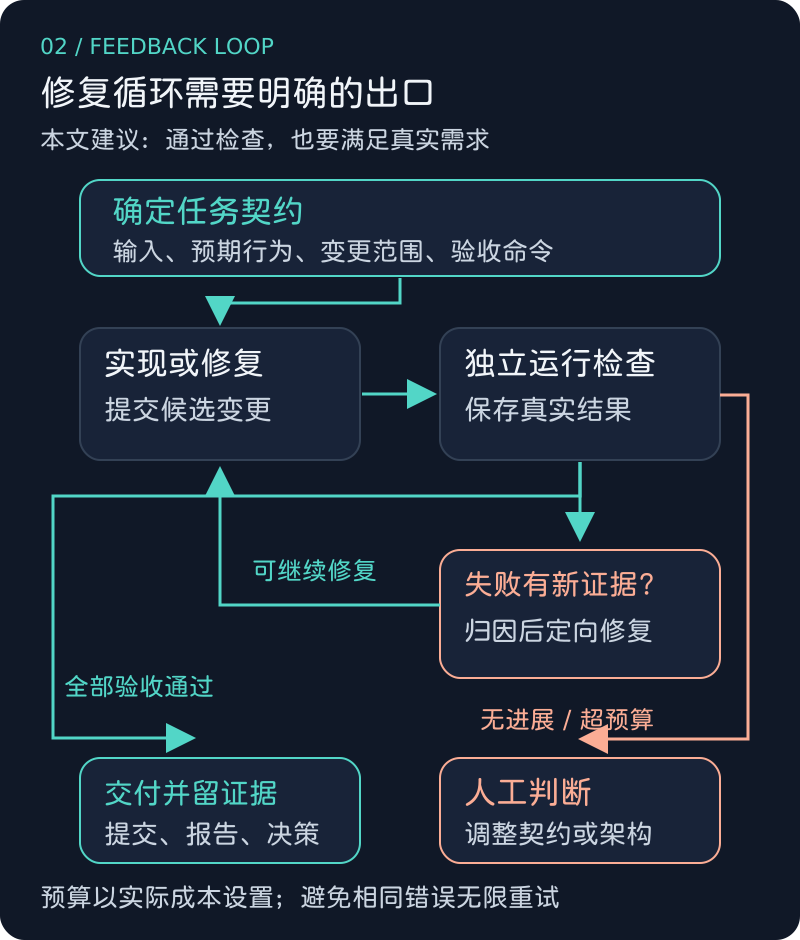
本文建议从一个明确的行为开始。 例如,做一个材质扫描工具时,先定义“扫描选中资产,输出指定参数;遇到无法读取的资产时记录错误并继续”,再决定测试和接口。
| 环节 | 最小产出 | 失败后应该做什么 |
|---|---|---|
| 契约 | 输入、输出、边界行为与修改范围 | 澄清矛盾,补充可观察的例子 |
| 实现 | 候选变更 | 定位具体故障,缩小修改 |
| 检查 | 针对当前提交的结果 | 按需求、代码或环境分别归因 |
| 交付 | diff、证据、已知限制 | 对未覆盖部分作明确记录 |
| 停止 | 无进展或预算耗尽的判据 | 交给人调整契约、设计或工具 |
“独立运行检查”表示由真实工具重新执行验收,不等于必须再启动一个 Agent。验收器应能确认它检查的是哪个提交,区分通过、失败和未运行。
对一段受保护的核心逻辑,执行者可以修改实现与新增测试,但删除回归断言、扩大忽略范围或降低阈值,应作为明确的验收规则变更审阅。否则,循环可能只把仪表盘修成绿色。
这项建议与 OpenAI 的评估审计相呼应:该研究发现,测试可能约束了需求未规定的实现细节,也可能遗漏功能要求。它审计的是基准任务;本文将“检查需求与测试是否一致”的原则用于项目验收。评估审计原文
第二步:检查测试能否抓住错误
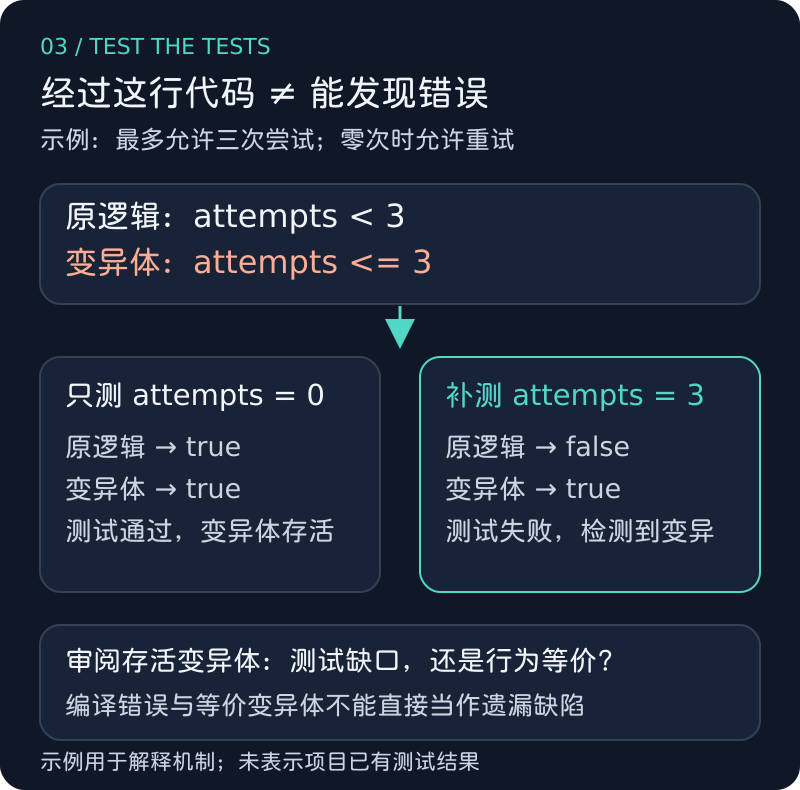
图中是一个解释性示例,尚未作为项目代码运行:
def can_retry(attempts: int) -> bool:
    return attempts < 3
只验证 can_retry(0) 为真,代码也会被执行。若逻辑错误地变成 attempts <= 3,这个测试仍然通过。补充“三次尝试时应为假”的断言,才会检测到这类边界错误。
变异测试通过小幅改变程序,观察测试是否检测到变化。报告需要区分被检测、存活、没有覆盖、编译失败等状态;Stryker 的指标会排除无法有效执行的变异体。官方指标说明
等价变异体也需要处理:代码变了,但可观察行为可能没变。对此应给出理由,避免为了分数添加没有意义的测试。Stryker 的处理说明
CRAP 能提示风险,但不能代替判断
CRAP 把圈复杂度与覆盖率结合起来:
其中 是圈复杂度, 是 0 到 1 的覆盖比例。以 为例:
| 覆盖比例 | CRAP,按公式计算 |
|---|---|
| 0% | 42 |
| 50% | 10.5 |
| 100% | 6 |
公式可在 Uncle Bob 的 Java 工具规格 中核对。不同工具使用的覆盖口径可能不同,该实现使用 JaCoCo 的指令覆盖率。
低分表示这套指标下的风险较低。 它没有衡量接口是否合适、测试是否断言正确、业务要求是否遗漏。圈复杂度衡量的是独立路径相关的结构复杂性,也不能理解为所有输入组合或路径都已测试。
本文建议先把 CRAP 当作定位高风险函数的线索。先看重复出错的逻辑,再考虑设置阈值;避免拆出大量薄包装函数,只为让数字下降。
把昂贵检查放到最有价值的位置
Google 的 Practical Mutation Testing at Scale 采用增量变异、过滤低价值变异体与限制数量来控制成本。这提供了比“每次全量运行”更实用的起点。
| 检查频率 | 本文建议的范围 |
|---|---|
| 每次修改 | 类型、静态检查、相关单测 |
| 合并前 | 核心行为、已有回归、必要的端到端验收 |
| 高风险改动 | 变化附近的边界断言和变异测试 |
| 定期维护 | 更广范围的依赖、重复与质量趋势检查 |
SWE-Lancer 的独立开发任务由经工程师多次核验的端到端测试评分。这提醒我们:测试用例本身也是需要验证的工程产物,而非天然正确的裁判。研究与作者信息
第三步:让模块边界保护下一次修改
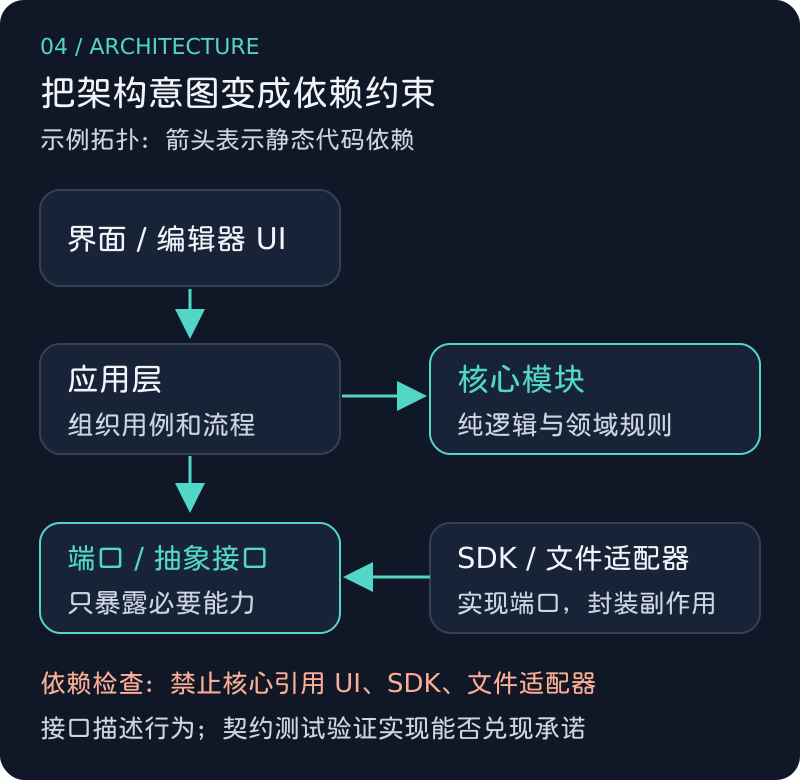
这是本文给出的示例拓扑,具体项目可以采用不同分层。关键是:依赖方向能检查,接口承诺能测试,外部副作用有明确入口。
以 Python 或 DCC 工具为例,扫描规则、参数转换、结果排序可以尽量成为可独立测试的逻辑;文件读取、引擎 API、编辑器 UI 放在外部适配层。以后替换 UI 或 SDK 时,变化就有机会留在边界附近。
| 问题信号 | 需要补上的约束 |
|---|---|
| 修改一个功能总要进入多个模块 | 重新审视职责及数据流 |
| 同一个 SDK 被很多业务文件直接调用 | 建立合适的适配边界 |
| 返回值能编译,但语义经常被误解 | 给契约增加例子、错误语义与测试 |
| 文档说不能反向依赖,代码仍然越界 | 加入可执行的依赖检查 |
| 接口很小,内部却承担无关职责 | 按变化原因重新划分模块 |
“深模块”应该隐藏实现细节,同时保持可检查的行为。接口如果只剩一个模糊的 execute(data),而错误类型、状态变化与输入条件都要靠猜,隐藏复杂度反而会扩大不确定性。
第四步:让上下文与知识能够交接
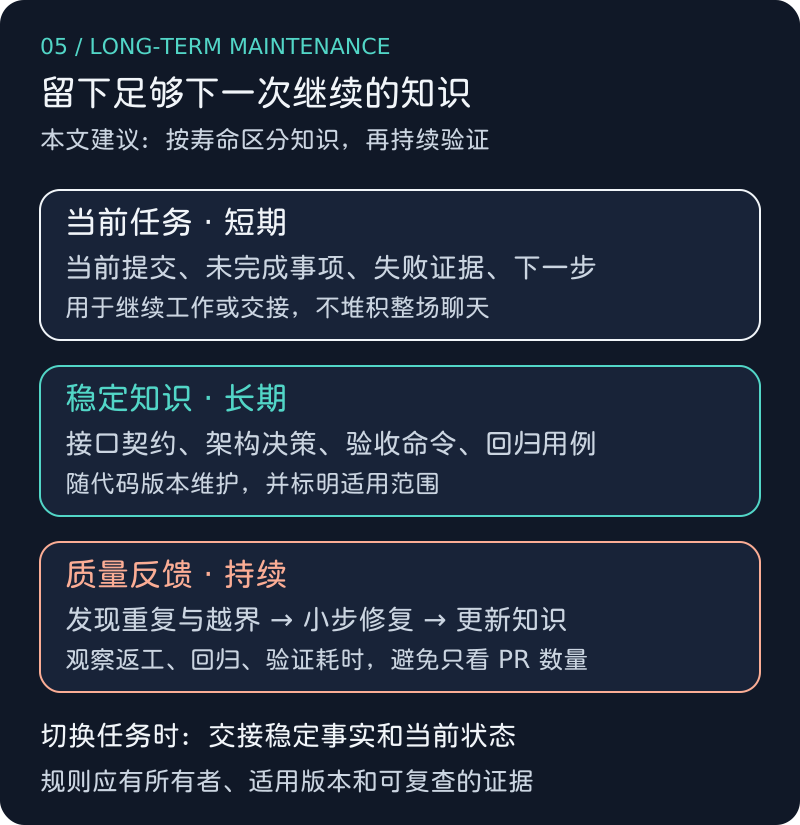
本文建议把长期项目的知识分成三类,而不把完整聊天记录都作为下一次任务的必读材料。
| 位置 | 存什么 | 怎样保持可信 |
|---|---|---|
AGENTS.md | 导航、主要命令、关键边界 | 简短,指向真实文档与代码 |
| 架构与决策文档 | 接口约束、取舍、适用范围 | 随行为变更更新,记录失效原因 |
| 当前任务记录 | 提交、剩余事项、失败证据、下一步 | 完成后压缩成稳定结论 |
进入新任务或切换会话时,先交接当前提交、相关契约、最近一次验证结果和未解决问题。是否需要新会话,要看任务与上下文是否仍一致,而不能套一个通用 token 分界。
也不要把一段流畅的执行总结当成完整审计。OpenAI 的可监控性研究讨论的是如何从模型信号识别行为,承认存在盲点及泛化限制。普通用户能看到的总结不等同于研究中的完整推理信号。本文因此建议优先保留工具结果、diff 和外部验收证据。研究及限制
对 TA 与个人开发者:先从一条真实工作流落地
不需要一次建设完整平台。选一项经常修改、已经有返工成本的工具,先建立一个可靠的反馈闭环。
| 项目 | 一开始就有用的验收 | 需要额外观察的部分 |
|---|---|---|
| Python / Blender / Maya 工具 | 核心变换结果、异常输入、资产写回行为 | 宿主版本、UI 操作、撤销与重入 |
| UE 插件 | 编译、核心逻辑回归、相关编辑器或运行时路径 | 生命周期、线程、资产加载和 GC 边界 |
| HLSL / 材质逻辑 | 合适的参考计算、输入边界、着色器编译 | 实际画面、精度、目标平台及 GPU 成本 |
这些是验收设计建议,并不表示本文已执行对应引擎测试。对于 GPU 逻辑,CPU 参考计算也不能单独证明渲染结果正确。
以玻璃材质为例,修改折射计算前,可以先固定向量方向、坐标空间、厚度单位、临界情况的预期,再保存能重复拍摄的测试场景。以后算法变化时,检查数值、画面与 GPU 成本是否符合要求,比只让 Agent “保持物理正确”更可操作。
可以直接用于下一项任务的执行模板
目标:完成一个可独立验收的行为变更。

先读取相关代码、接口契约和现有验收命令。
给出输入、预期输出、关键边界以及必要的修改范围。

按项目既有架构实现;遇到失败时先定位原因。
运行与改动相关的检查,保存实际命令、结果和对应提交。
已有回归断言、忽略范围与验收阈值的变化须单独说明理由。

若连续重试没有获得新证据,或达到本次工作预算,
停止扩大修改,报告阻塞原因和需要判断的取舍。

交付:变更摘要、验收证据、未覆盖部分、
接口或决策文档更新,以及下一步建议。
具体预算按任务设置。这份模板没有保证一次成功,它要求每次失败都能留下有用的信息。
用后续修改检验今天的设计
本文建议每周回看几个真实变化:
- 同类问题是否反复出现,是否已经有有效回归用例。
- 一个小需求是否仍能在有限模块内完成。
- 检查耗时是否增长,是否有无效重复验证。
- 新 Agent 能否依据仓库资产继续工作。
- 技术债清理是否缩小了后续修改范围。
少量 PR、较低的复杂度或漂亮的图表都不能单独证明可维护性。观察后续任务遇到什么困难,再把已确认的经验沉淀成契约、工具或回归用例,才有机会让工程判断持续生效。
延伸阅读与来源
站内可以继续阅读 个人开发者如何落地可靠的 Agent 工作流 和 为什么和 Agent 协作会越来越累。
| 来源 | 本文使用范围 |
|---|---|
| Matt Pocock × Uncle Bob 节目;公开转录 | 全场议题与时间导航 |
| OpenAI · Harness engineering | Ryan Lopopolo 团队的工程实践及长期未知项 |
| OpenAI · SWE-Lancer | 研究任务与端到端验收方法 |
| OpenAI · Separating signal from noise | 需求与测试一致性的评估审计 |
| OpenAI · Monitorability | 监控有效性与限制 |
| crap4java 规格 | CRAP 公式与覆盖口径 |
| Stryker 指标;等价变异体 | 变异结果的解释 |
| Practical Mutation Testing at Scale | 增量检查与成本控制 |
资料核对日期:2026-10-02。流程、模板和 TA 场景均为本文综合建议,尚未提供特定项目的实测数据。